Par Tamsi Besson ·
Mistral Large 4, le Chonk : 38 à l’indice, 3 800 GPU, et ce que l’Europe peut en faire
Preview du 6 octobre 2026. Fort sur le cyber ouvert et le grounding, au niveau de GPT-6 Luna sur l’indice, entraîné sur 3 800 GPU.
- Mistral
- Le Chonk
- Benchmarks
- GPUs
- Europe
Le 6 octobre 2026, Mistral a ouvert la preview publique de Mistral Large 4. Dans le billet, le surnom est assumé : le Chonk. Environ 1 000 milliards de paramètres, 49 milliards actifs par token, images et texte en entrée, texte en sortie. L’API répond aujourd’hui. Les poids sont promis pour la fin du mois. Reuters a écrit le 27 octobre. La page Hugging Face du dépôt à venir compte jusqu’au 31. La licence n’est pas dans le billet.
Le film du post X dure 17 secondes. L’image est un chat roux, de dos, dans une galerie à colonnes, face à un 4 orange en gros pixels. Dans les cadres dorés, les portraits sont des chats. Chonk est le mot anglais pour un chat épais. Mistral l’a gardé, avec l’article français. C’est la partie du lancement qui se comprend sans relire un axe.
Ce qui est sorti
Le modèle est un mixture-of-experts multimodal, entraîné depuis zéro. Le billet dit 49 milliards de paramètres actifs. Le nom du dépôt Hugging Face, Mistral-Large-4.0-1T05-A52B, précise 1,05 T au total et 52 milliards en comptant les embeddings et la couche de sortie. L’identifiant d’API est mistral-large-4.
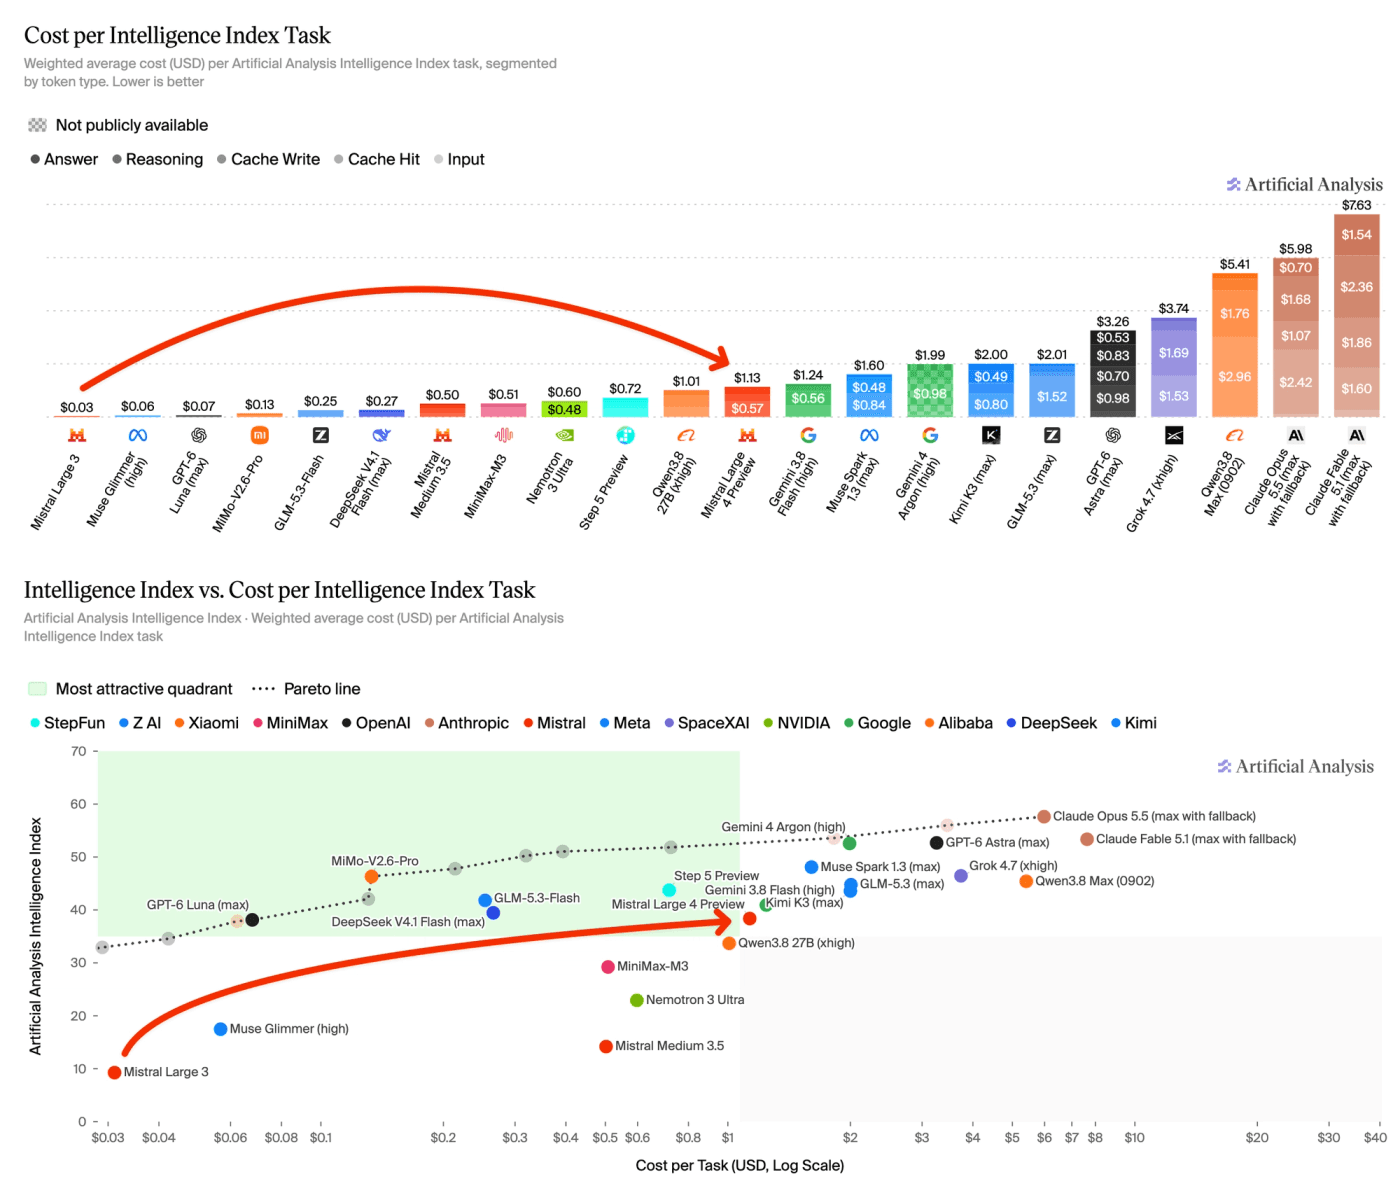
- Prix affiché : 1,36 $ le million de tokens en entrée, 4,18 $ en sortie, 0,14 $ pour l’entrée mise en cache. Moitié prix les deux premières semaines, soit 0,68 $ et 2,09 $. Artificial Analysis en tire 1,13 $ par tâche de son indice, 0,57 $ pendant la promo.
- Fenêtre de la preview : 524 000 tokens sur la fiche Artificial Analysis. Leur article du même jour arrondit à 512 000. L’API accepte jusqu’à 100 images par requête, contre 8 sur les modèles Mistral d’avant.
- Deux accès pendant la preview. L’API publique, avec les garde-fous. Une version à modération réduite pour des partenaires cybersécurité et des autorités, le temps du red team. Le billet laisse dans le flou quelle version a produit les barres de cyber.
- Vitesse mesurée par Artificial Analysis : 116 tokens par seconde.
Mistral écrit que le modèle dépasse nettement tout modèle à poids ouverts entraîné aux États-Unis ou en Europe, et qu’il est compétitif avec les plus forts modèles ouverts au monde. La deuxième phrase fait le travail de la première. La Chine n’est pas dans « États-Unis ou Europe ». Sur l’indice général, les modèles chinois sont devant.
Pourquoi c’est faible
Le chiffre que je retiens d’abord est 38. C’est le score de la preview sur l’Intelligence Index v4.3.2 d’Artificial Analysis, dix évaluations mêlées (agents, code, raisonnement, documents). Le même indice met GPT-6 Luna, le petit modèle d’OpenAI, à 38, et DeepSeek V4.1 Flash à 39. Les lectures publiées le jour du lancement placent Claude Opus 5.5 vers 58, GPT-6 Astra, Gemini 4 Argon et Claude Fable 5.1 vers 53, MiMo-V2.6-Pro à 46, GLM-5.3 et Qwen3.8 Max vers 45, Kimi K3 à 44. Mistral Large 3 était à 9. Le saut est réel. Le niveau atteint est celui d’un modèle d’entrée de gamme américain, derrière les meilleurs ouverts chinois.
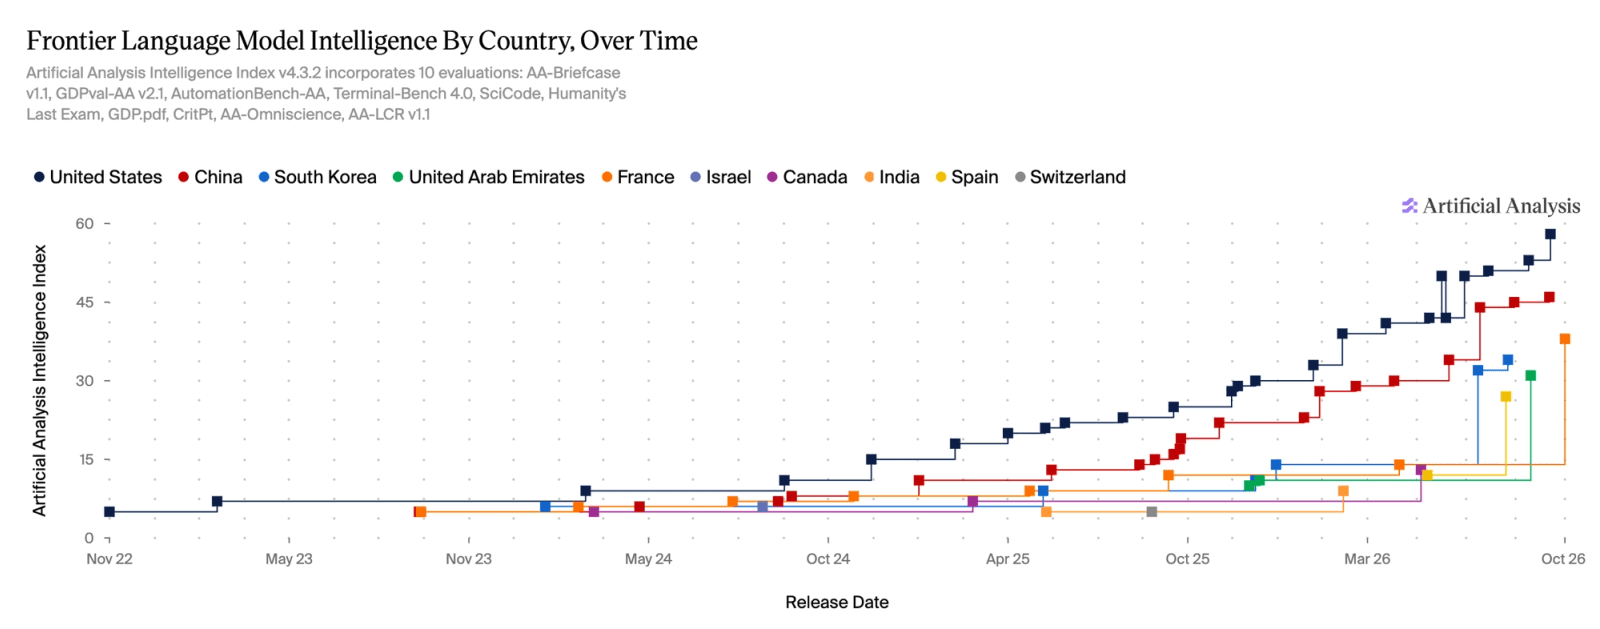
Le prix suit la même pente. À tarif liste, Large 4 coûte 1,13 $ par tâche d’indice. Luna, à score égal, est à 0,07 $. MiMo-V2.6-Pro, huit points au-dessus, est à 0,13 $. GLM-5.3-Flash, à 0,25 $, et DeepSeek V4.1 Flash, à 0,27 $. La promo à 0,57 $ dure deux semaines et laisse le modèle au-dessus de ces quatre-là. Sur le graphique coût contre score, le Chonk est hors du quadrant qu’Artificial Analysis teinte en vert.
Le code
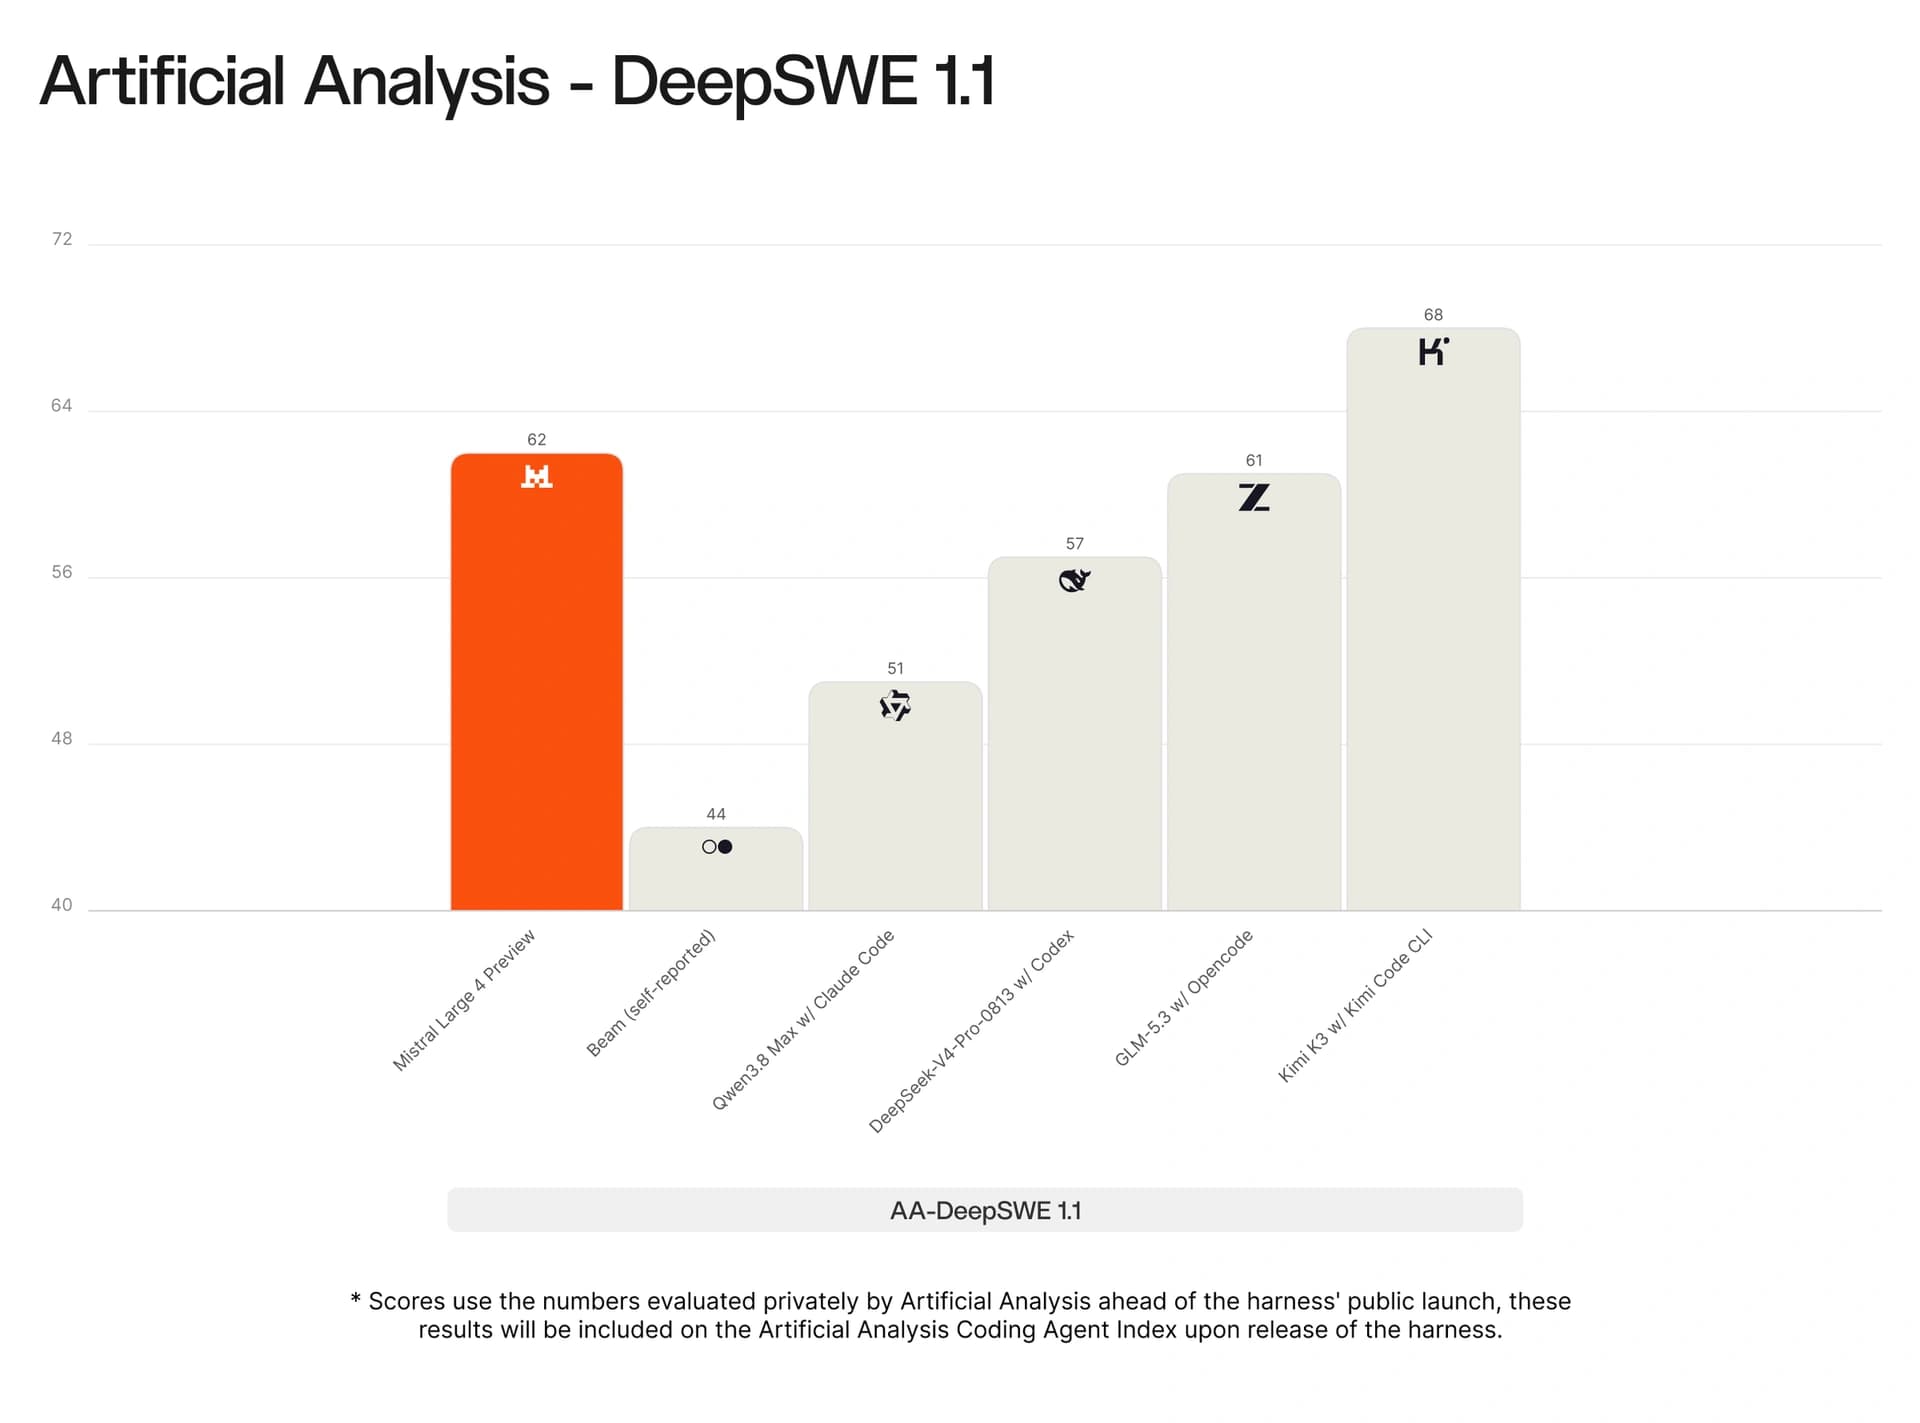
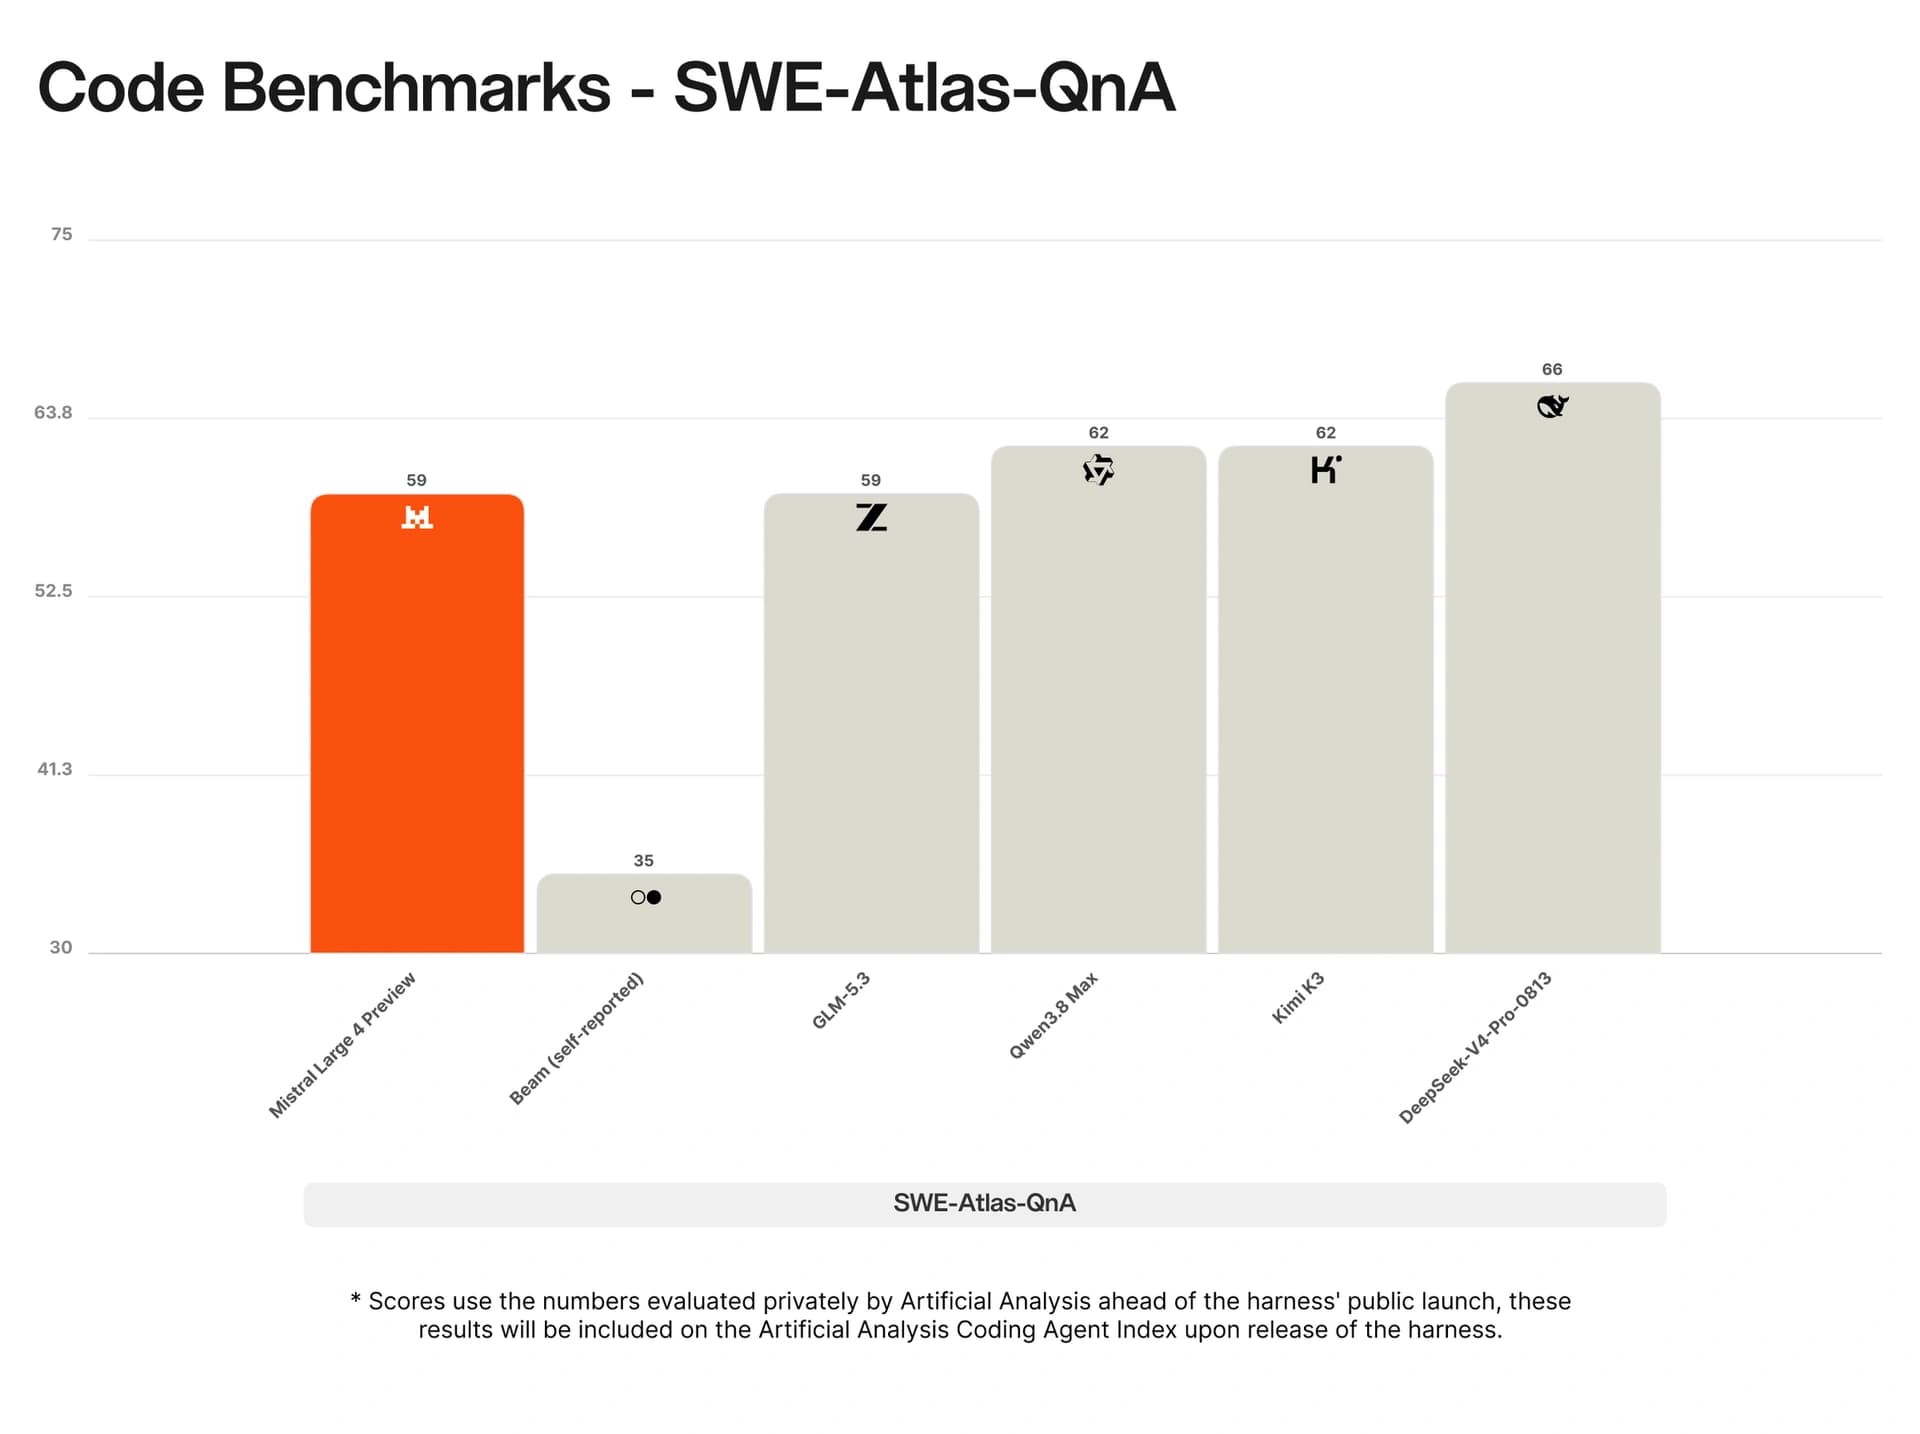
Mistral annonce 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA, 28,3 % sur Terminal-Bench 4, et une moyenne appelée Coding Agent Index à 49,8 %. Cette moyenne passe devant DeepSeek V4 Pro 0813 et Qwen3.8 Max. Elle est tirée vers le haut par DeepSWE et vers le bas par le terminal. Les graphiques du billet portent une note : scores calculés en privé par Artificial Analysis avant la publication du harness, et ces barres doivent rejoindre l’index plus tard. Chaque modèle y est dans son propre outil. Kimi est dans Kimi Code CLI, DeepSeek dans Codex, Qwen dans Claude Code, GLM dans opencode. Je lis ça comme un ordre de grandeur, pas comme un classement figé.
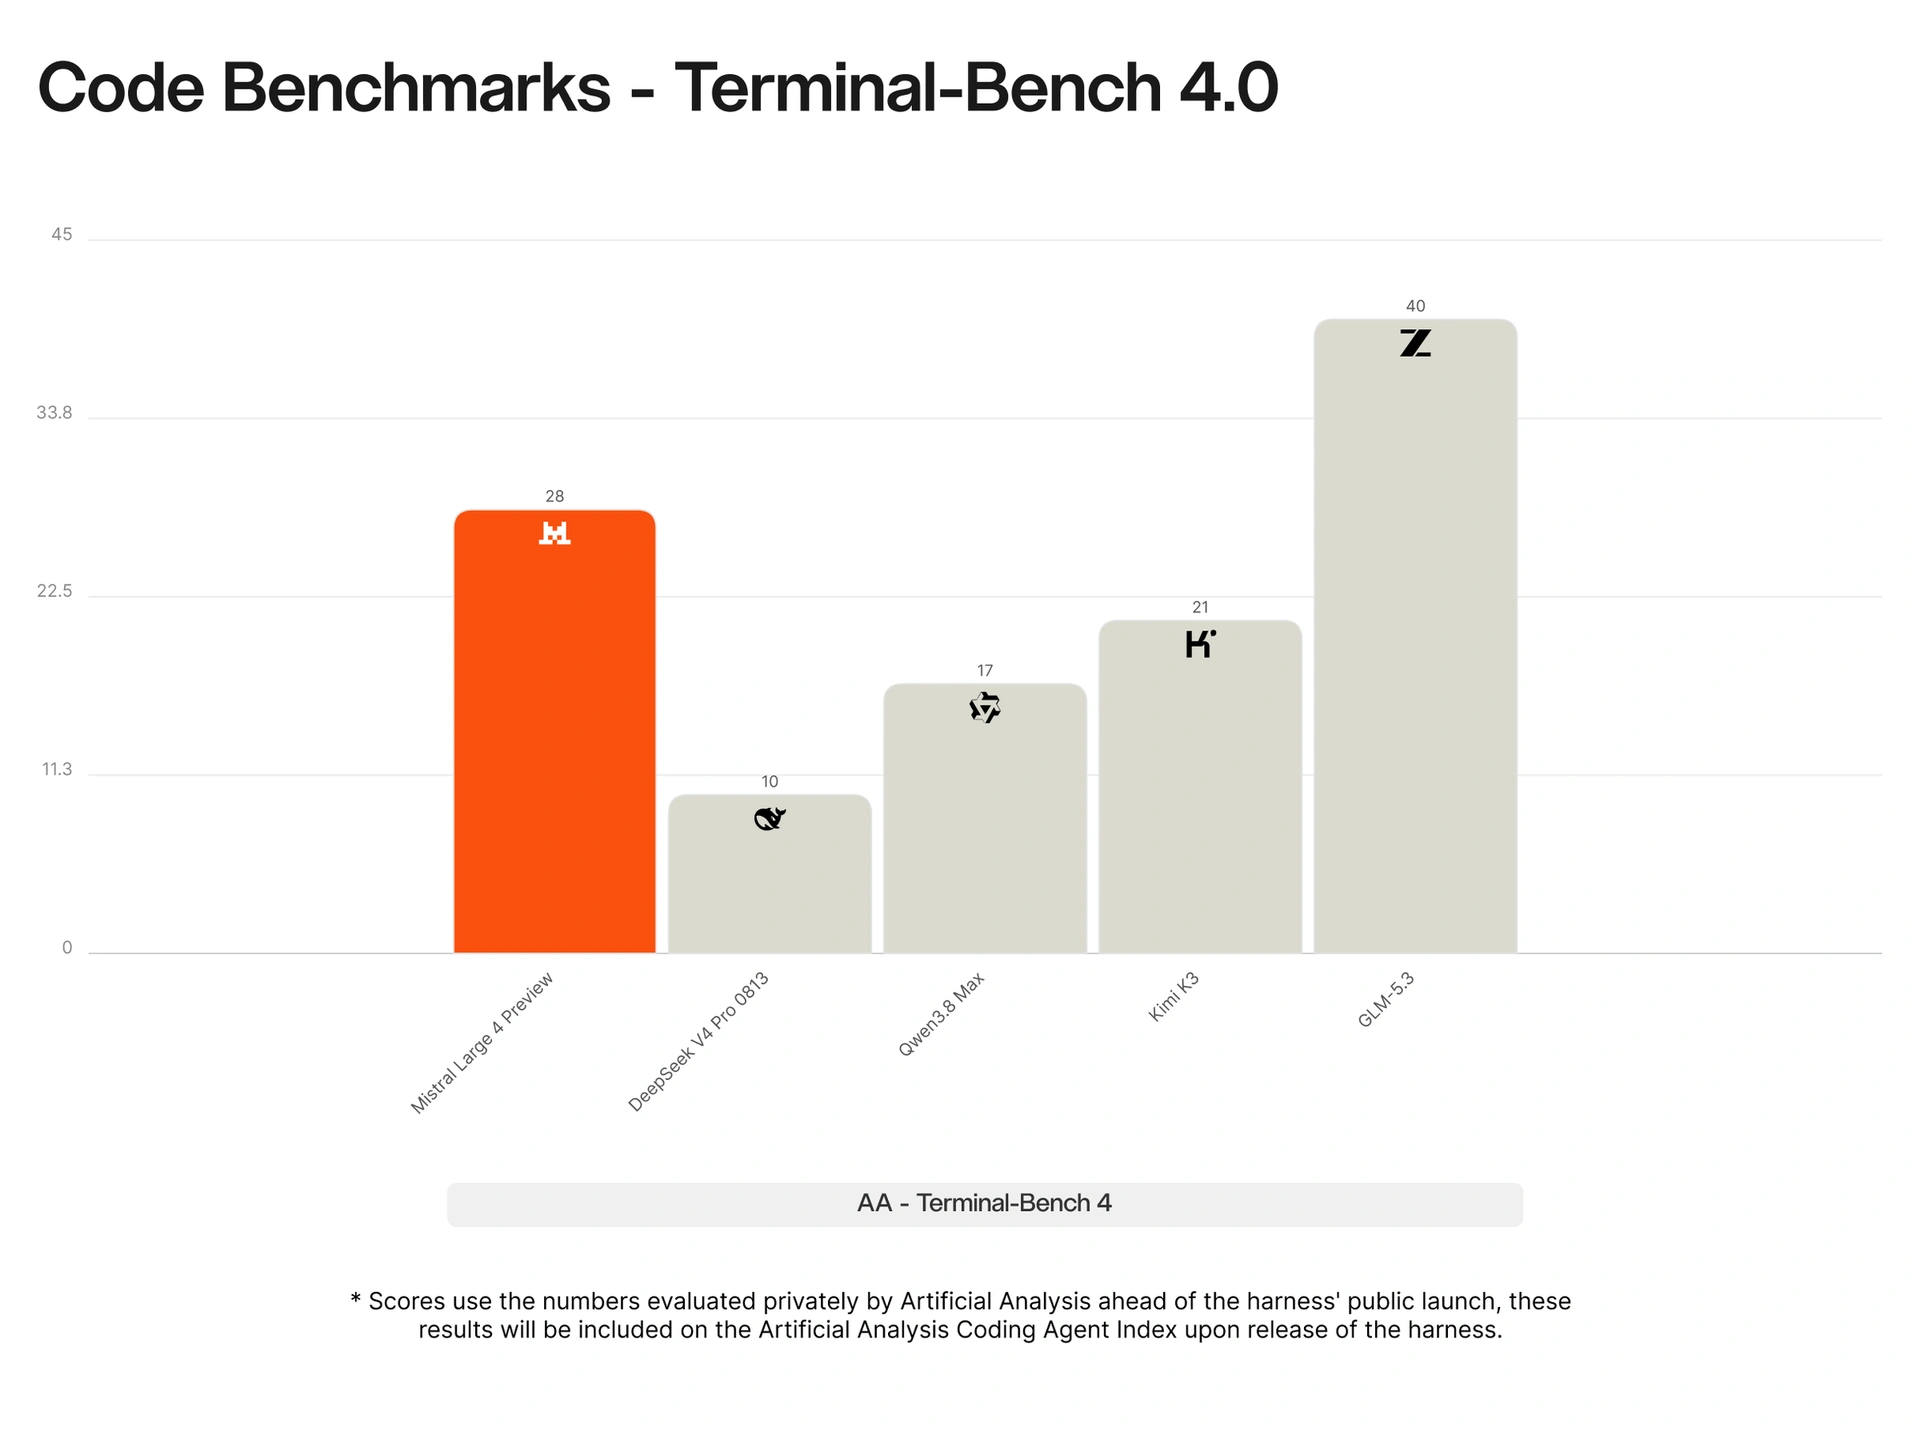
Sur le même nom de benchmark, Anthropic annonce 70,6 % pour Sonnet 5.5. Les harness ne sont pas les mêmes, donc je ne soustrais pas 70,6 et 28 pour en faire un écart mesuré. Je note juste que le graphique de Mistral s’arrête aux modèles ouverts, et que GLM-5.3 y est déjà à 40.
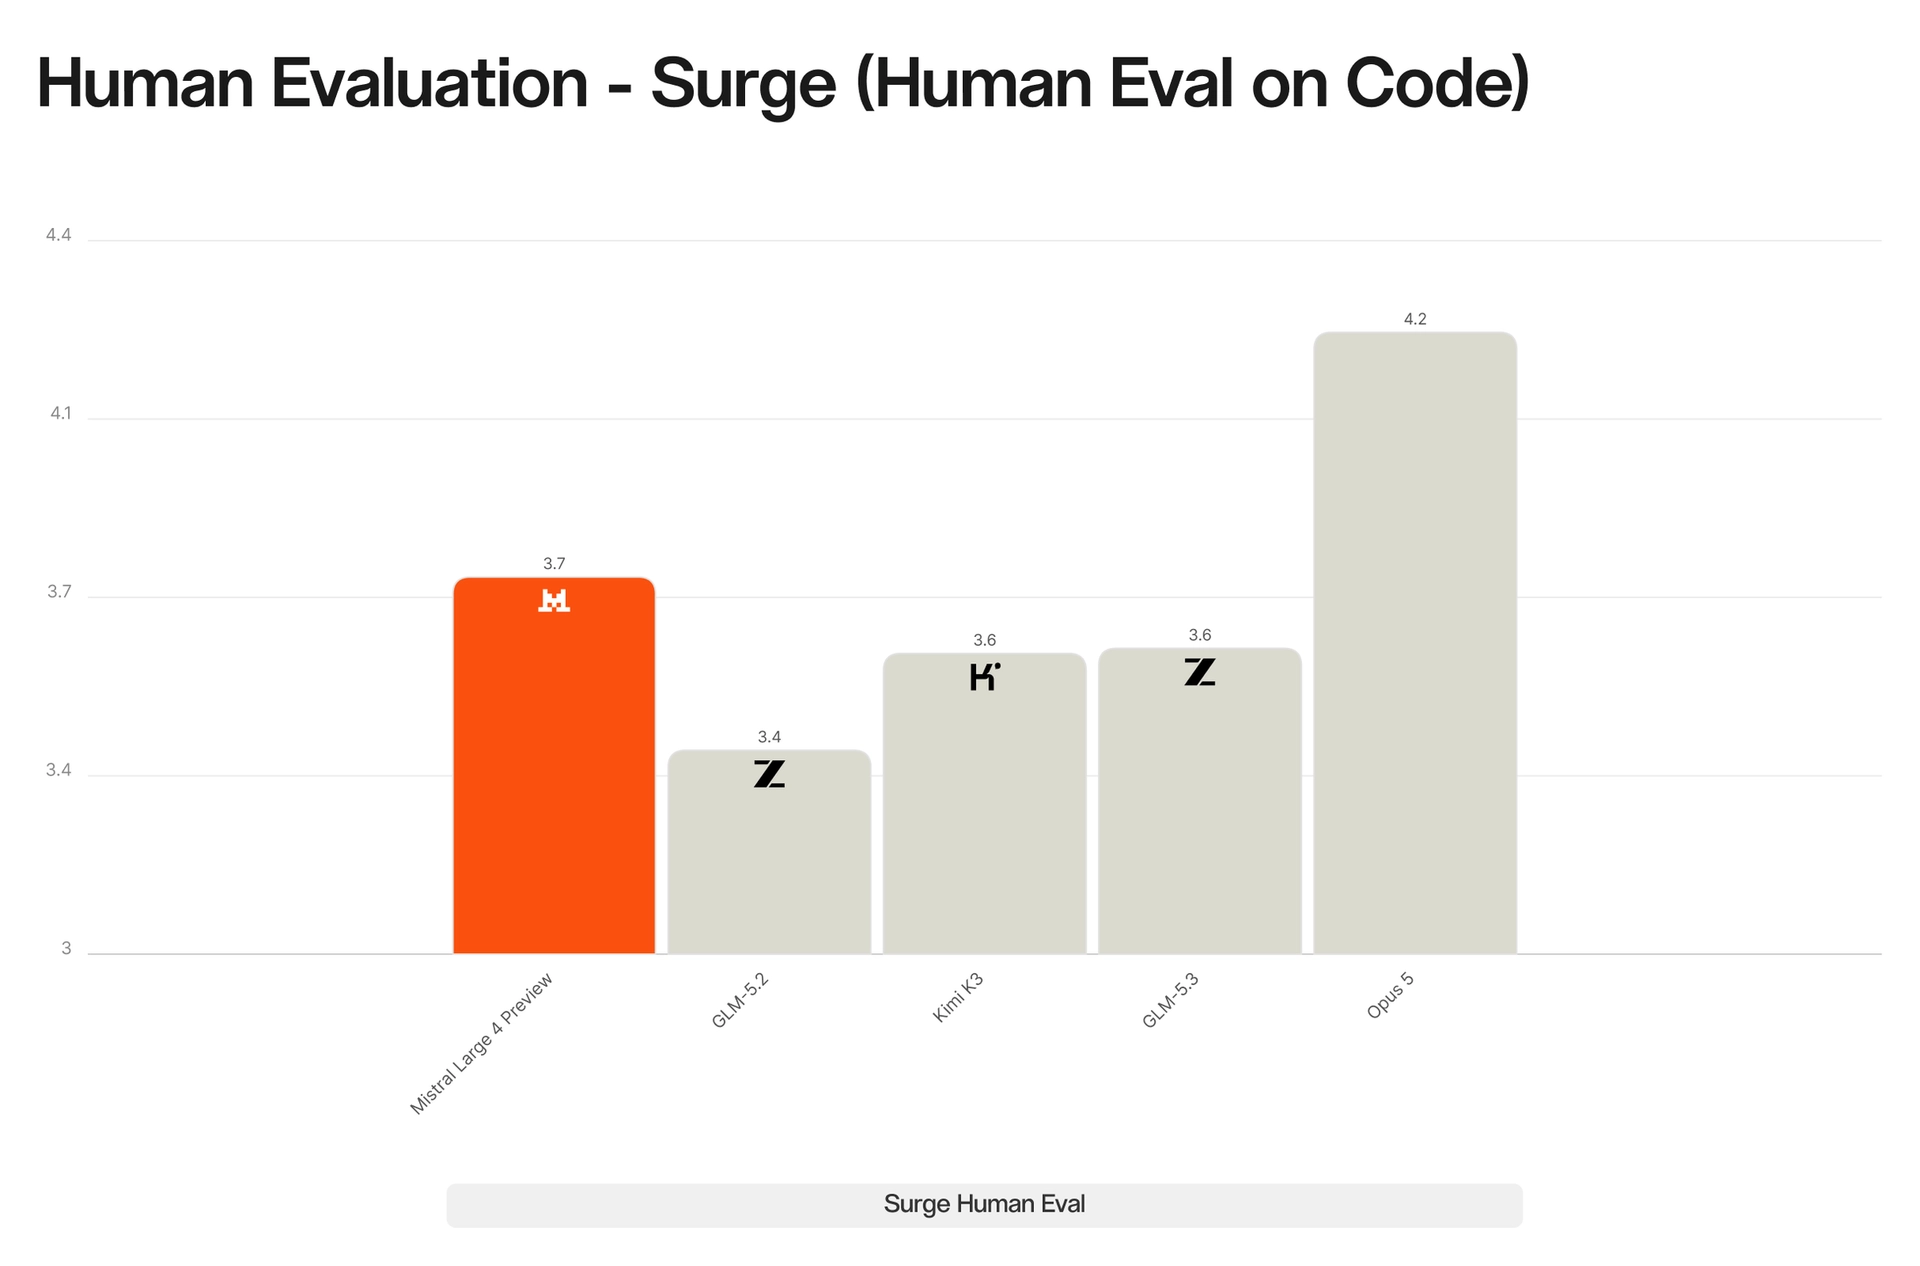
L’évaluation humaine de Surge, à l’aveugle, est plus gentille que le terminal. Des annotateurs notent le code de 1 à 5 sans savoir quel modèle parle. Le billet donne 3,74 à Large 4, deuxième sur cinq, derrière Claude Opus 5 à 4,22, devant Kimi K3 à 3,59, GLM-5.3 à 3,60 et GLM-5.2 à 3,40. Le graphique arrondit. Opus 5, pas Opus 5.5. L’écart avec Claude reste visible. L’écart avec Kimi et GLM est mince.
Le cyber
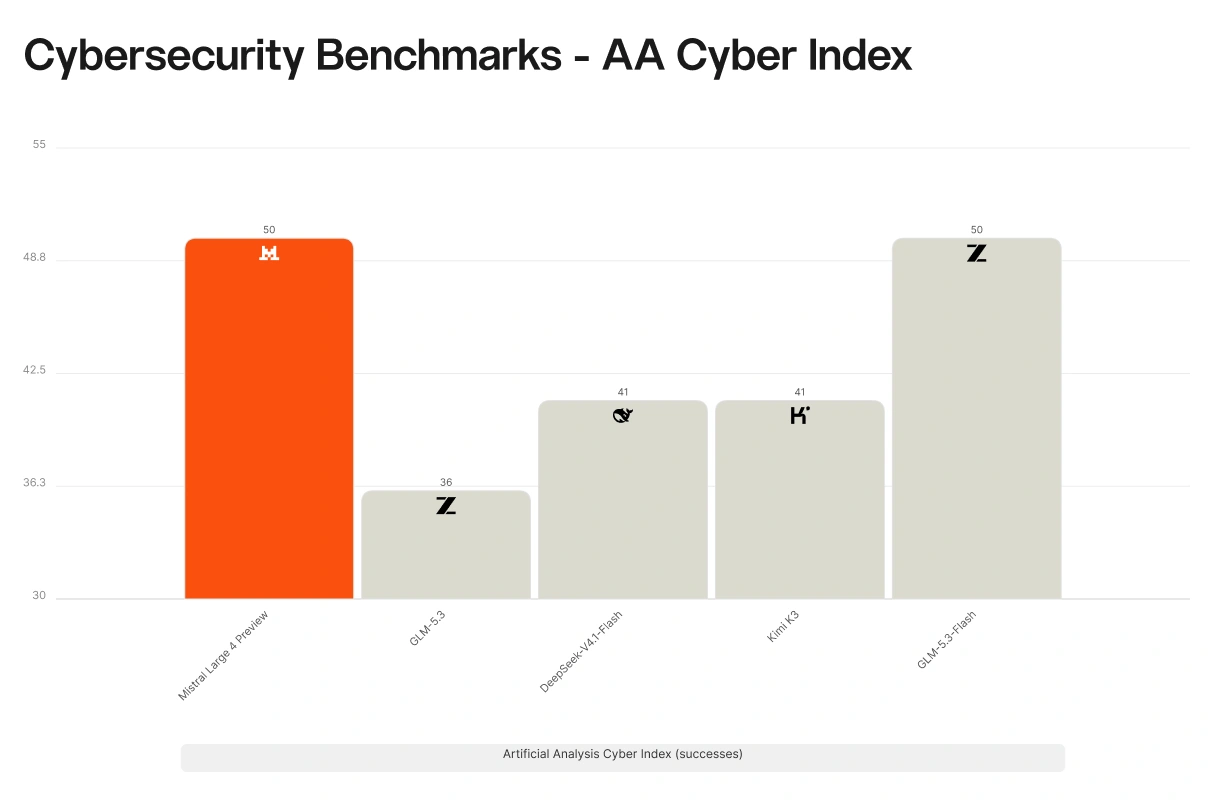
C’est le chapitre où le billet parle le plus fort, et celui où le cadrage change le plus la lecture. L’indice cyber d’Artificial Analysis moyenne trois tests : CWE-Bench, DeepSecBench, CyberGym-E2E. Large 4 y est à 50. À égalité avec GLM-5.3-Flash. Derrière MiMo-V2.6-Pro et Grok 4.7, à 56, et derrière GPT-6 Luna, à 53. Devant Kimi K3 et DeepSeek V4.1 Flash, à 41, et devant GLM-5.3, à 36.
Le graphique publié par Mistral sous le même nom d’indice montre cinq barres : Large 4 à 50, GLM-5.3 à 36, DeepSeek V4.1 Flash à 41, Kimi K3 à 41, GLM-5.3-Flash à 50. Les quatre modèles du jour qui font au moins aussi bien (Grok, MiMo, Luna, et le flash déjà à égalité) ne sont pas tous là. Grok, MiMo et Luna manquent. L’axe commence à 30, donc 50 contre 36 occupe beaucoup plus de place que quinze points.
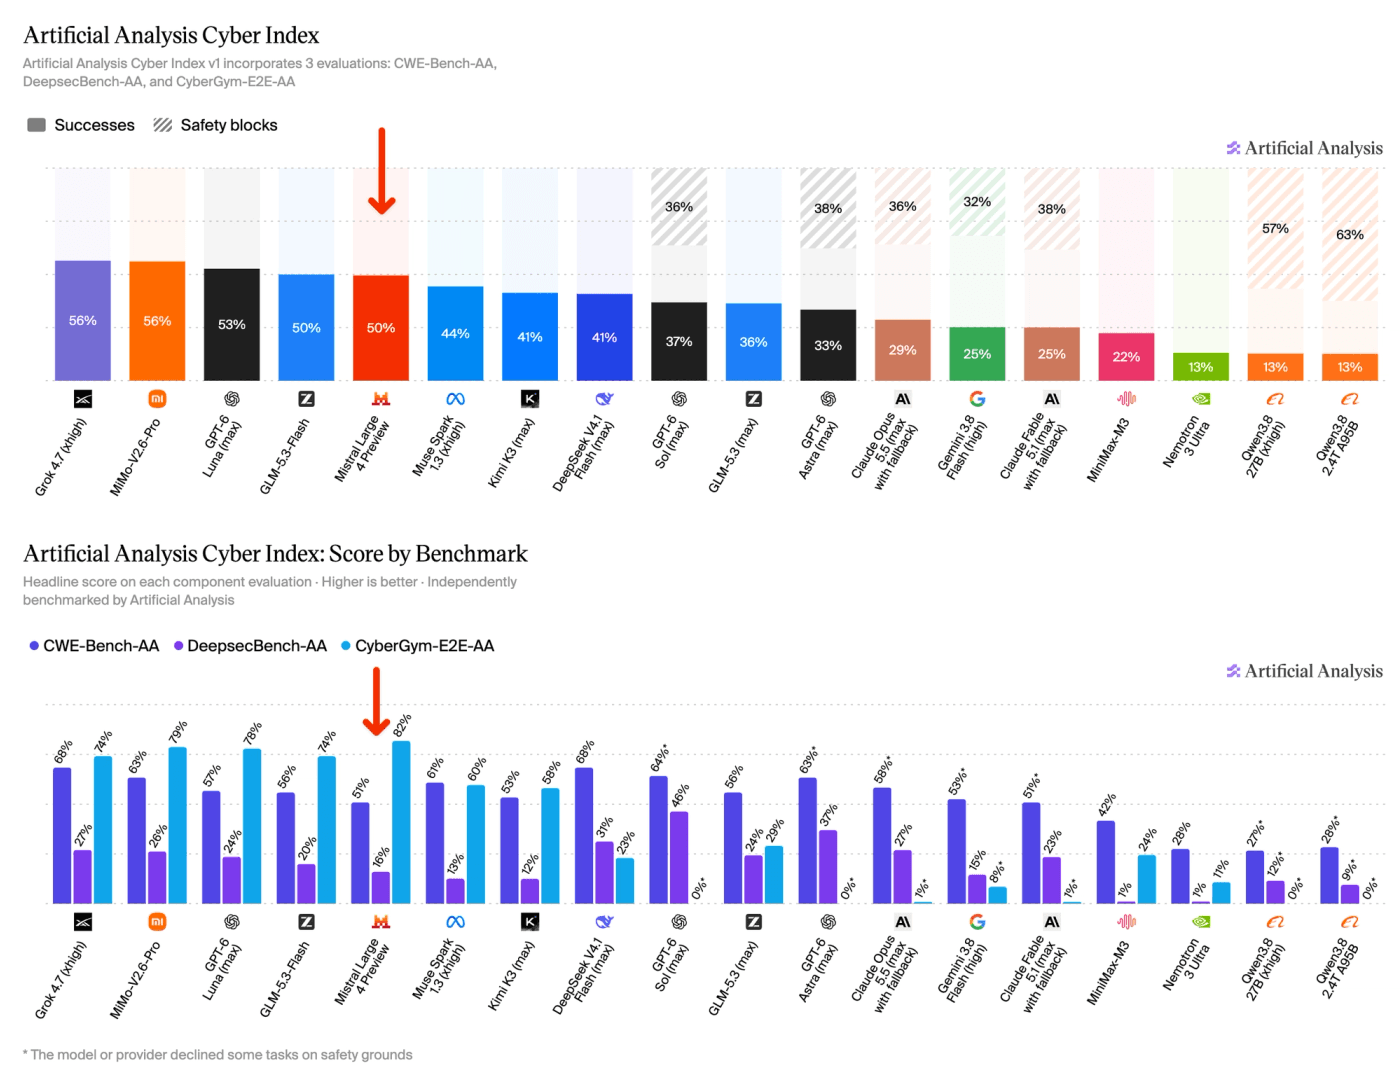
Le 50 est inégal. Sur CyberGym-E2E, où il faut reproduire une vraie faille puis la corriger, Large 4 est à 82 %, devant MiMo à 79 % et, dans le détail d’Artificial Analysis, devant GPT-6 Luna à 78 %. Sur CWE-Bench, Large 4 est à 51 %, sous MiMo à 63 %. Sur DeepSecBench, 16 %, sous MiMo à 26 %. Le titre « un des plus forts modèles cyber au monde » repose sur un test sur trois, plus une place dans le top cinq de l’indice une fois qu’on accepte les refus des modèles fermés comme des zéros.
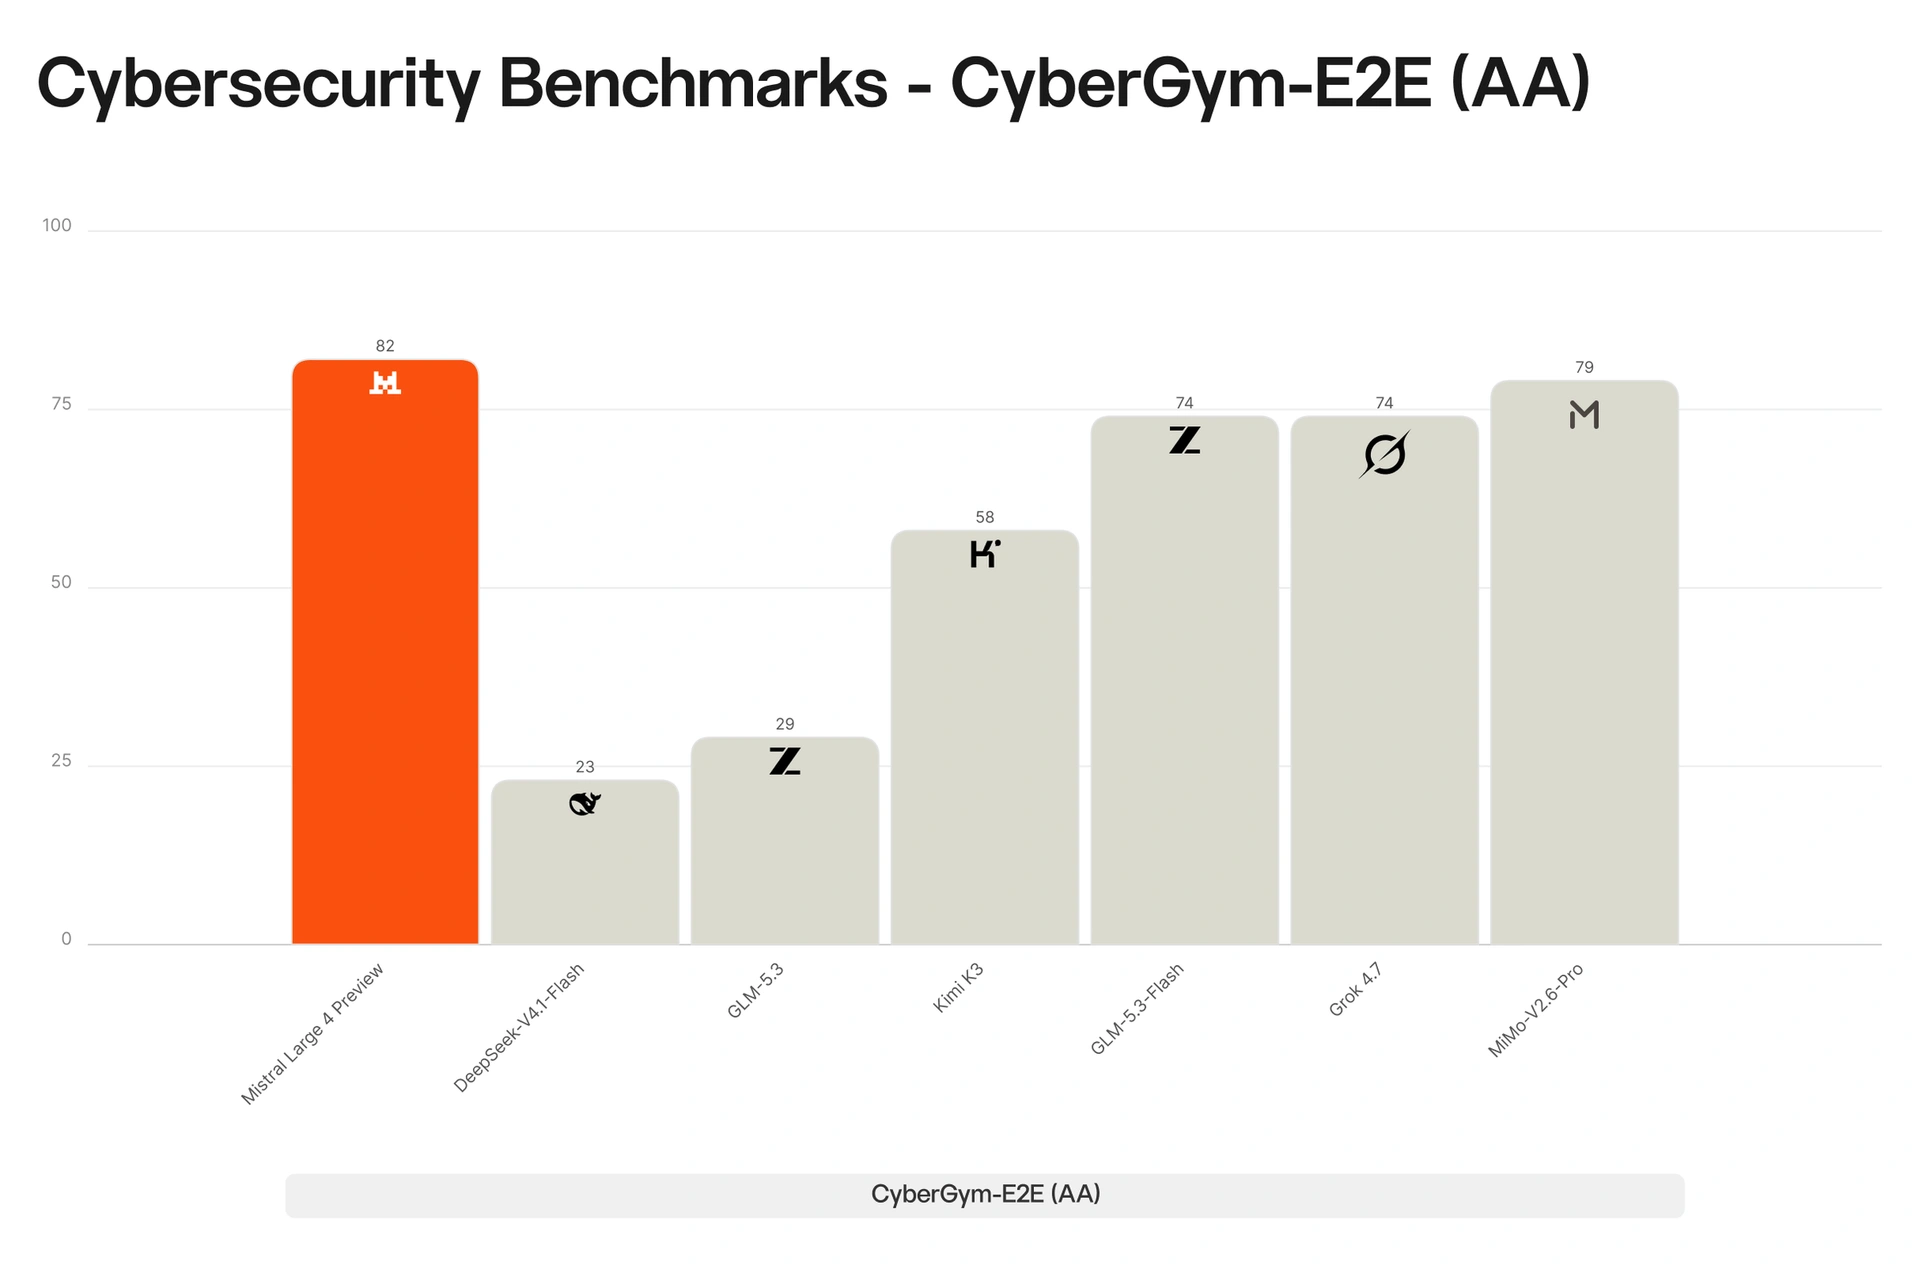
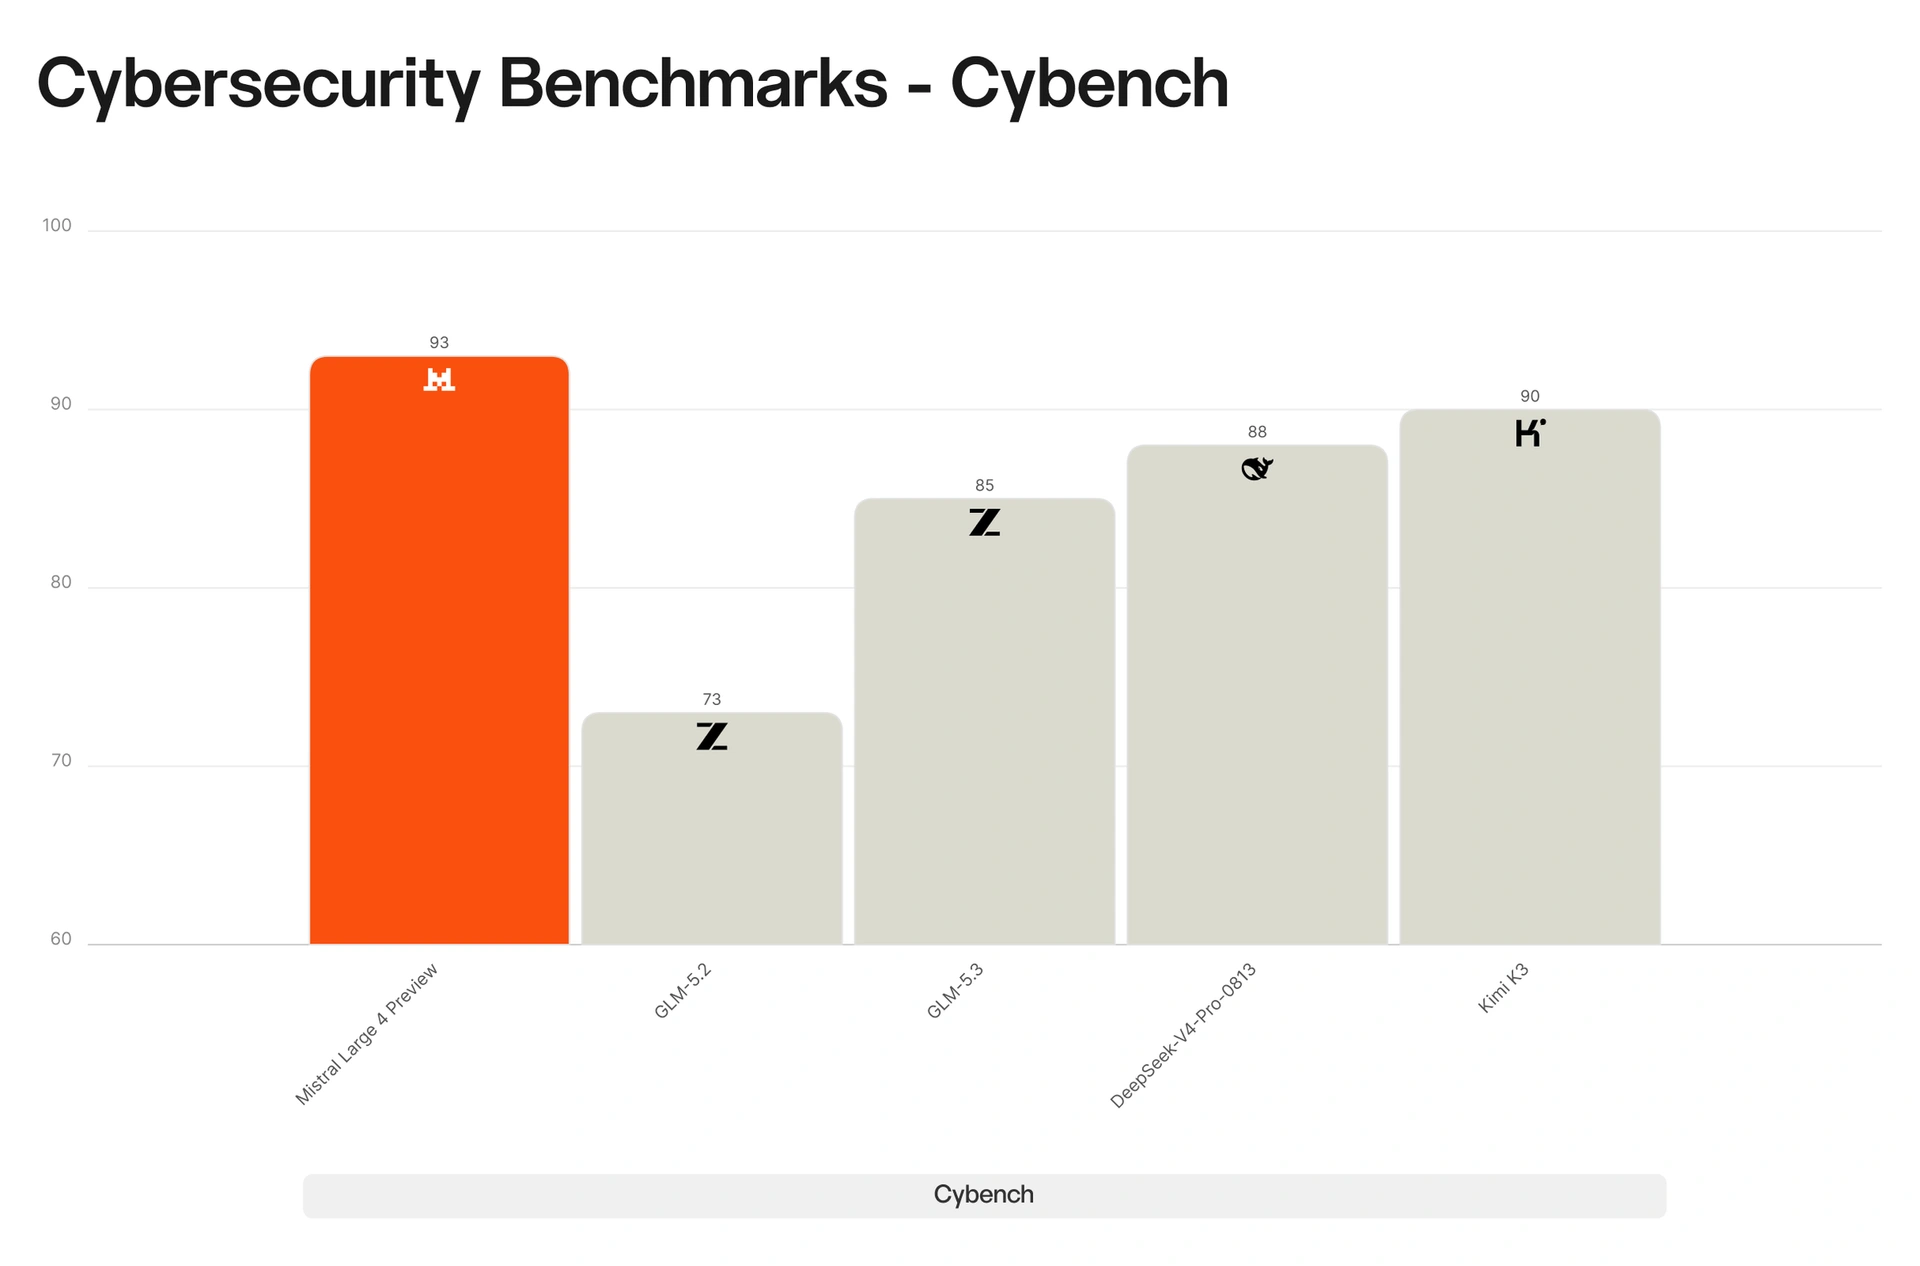
Cybench, 40 exercices tirés de compétitions de sécurité, n’est pas dans l’indice d’Artificial Analysis. Mistral l’a fait tourner : 93, devant Kimi K3 à 90, DeepSeek V4 Pro à 88, GLM-5.3 à 85. Trois points sur 40 exercices, c’est de l’ordre d’un défi. L’axe du graphique commence à 60, ce qui transforme ces trois points en falaise.
Mistral écrit que Claude Opus 5.5 et GPT-6 Astra sont proches de zéro sur le test « reproduire la faille puis la patcher », parce qu’ils refusent. Le graphique Artificial Analysis met une astérisque sur les modèles qui déclinent des tâches, et une part hachurée parfois énorme sur Opus, Astra, Fable. Une partie de l’écart avec les modèles fermés vient de leur politique de refus. C’est l’argument produit de Mistral, et il tient pour un défenseur. Un 50 d’indice laisse Luna, qui répond, à 53.
Droit, finance, agents, images
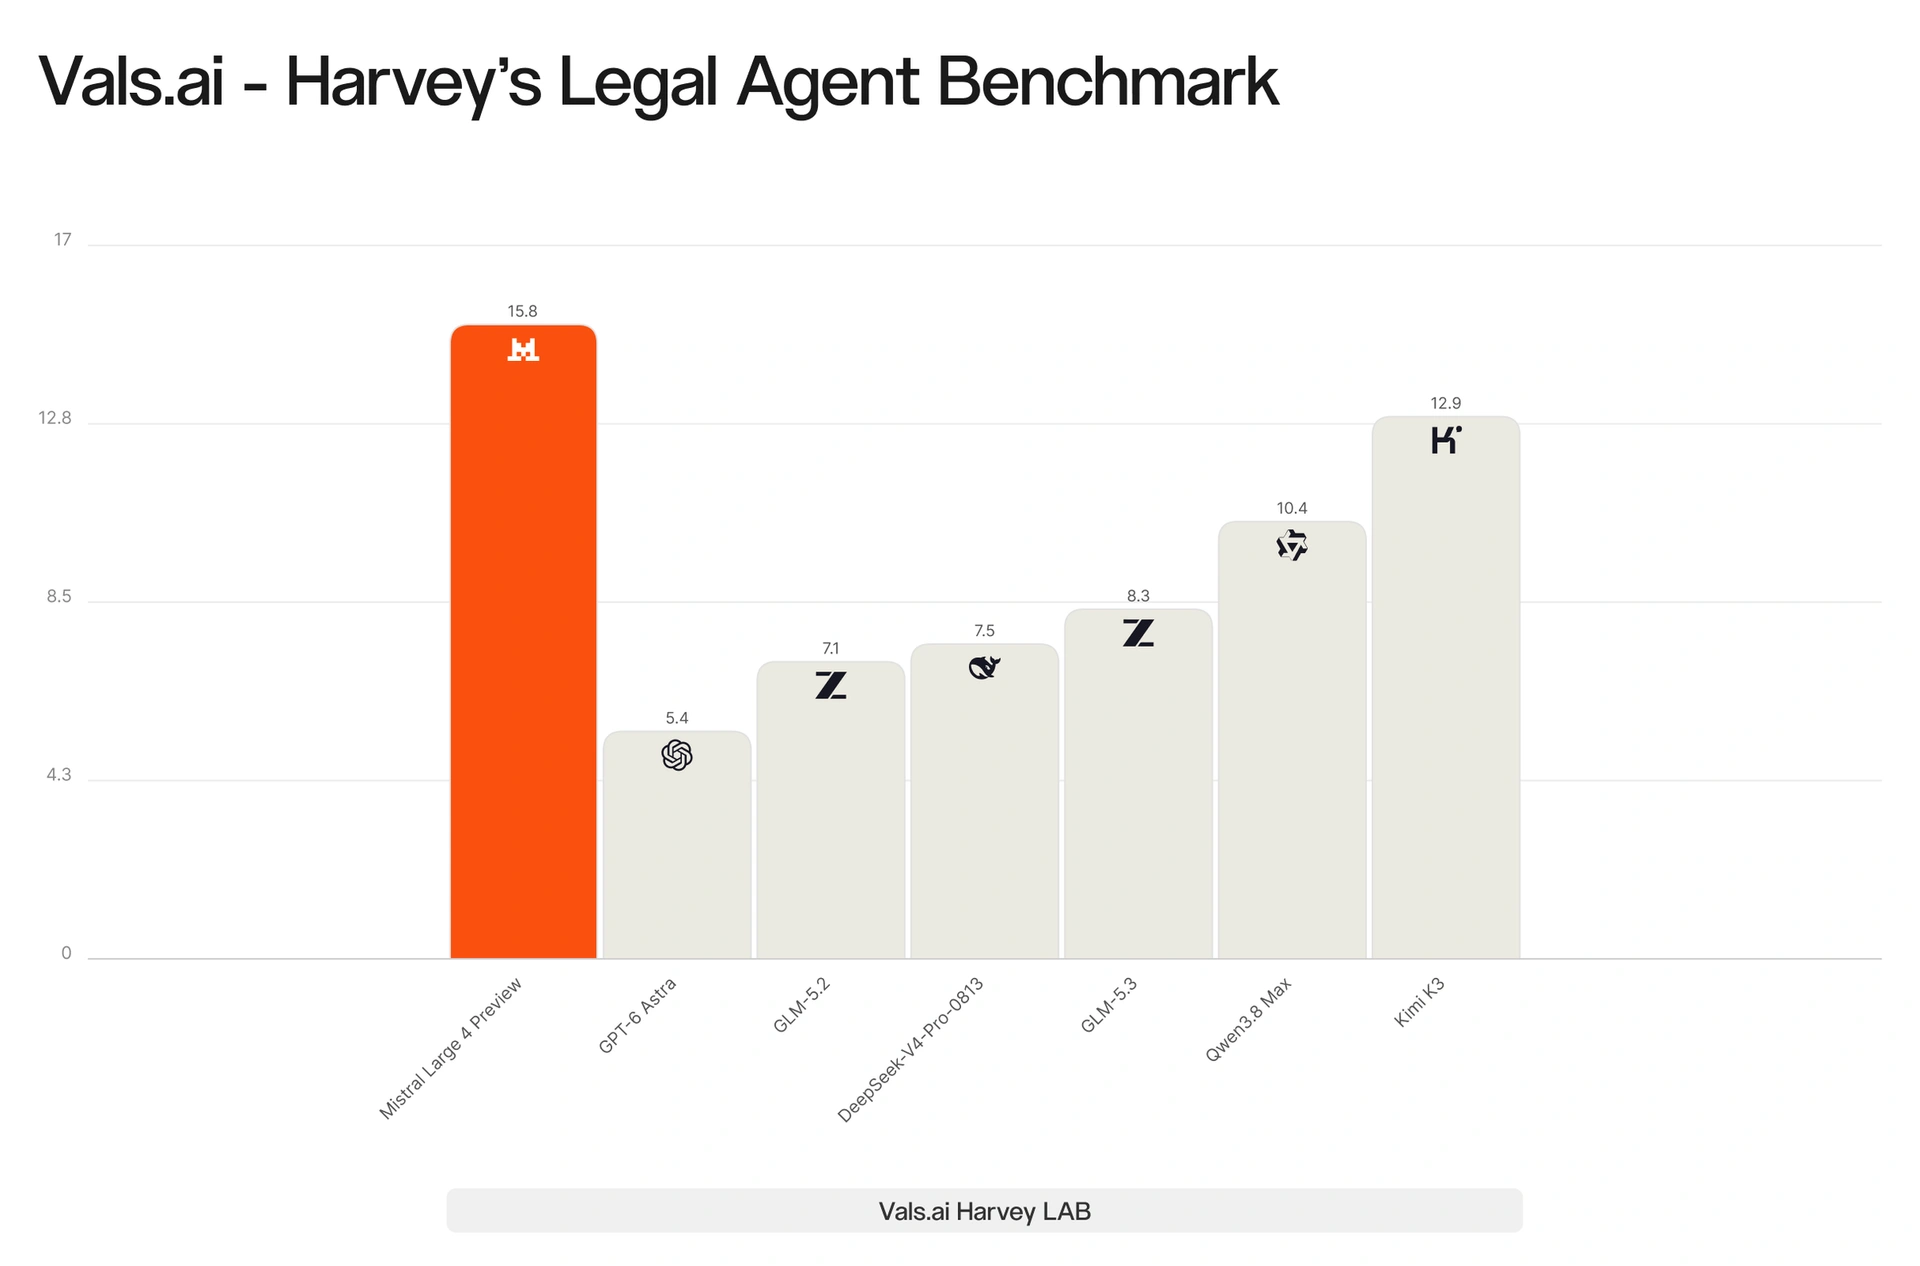
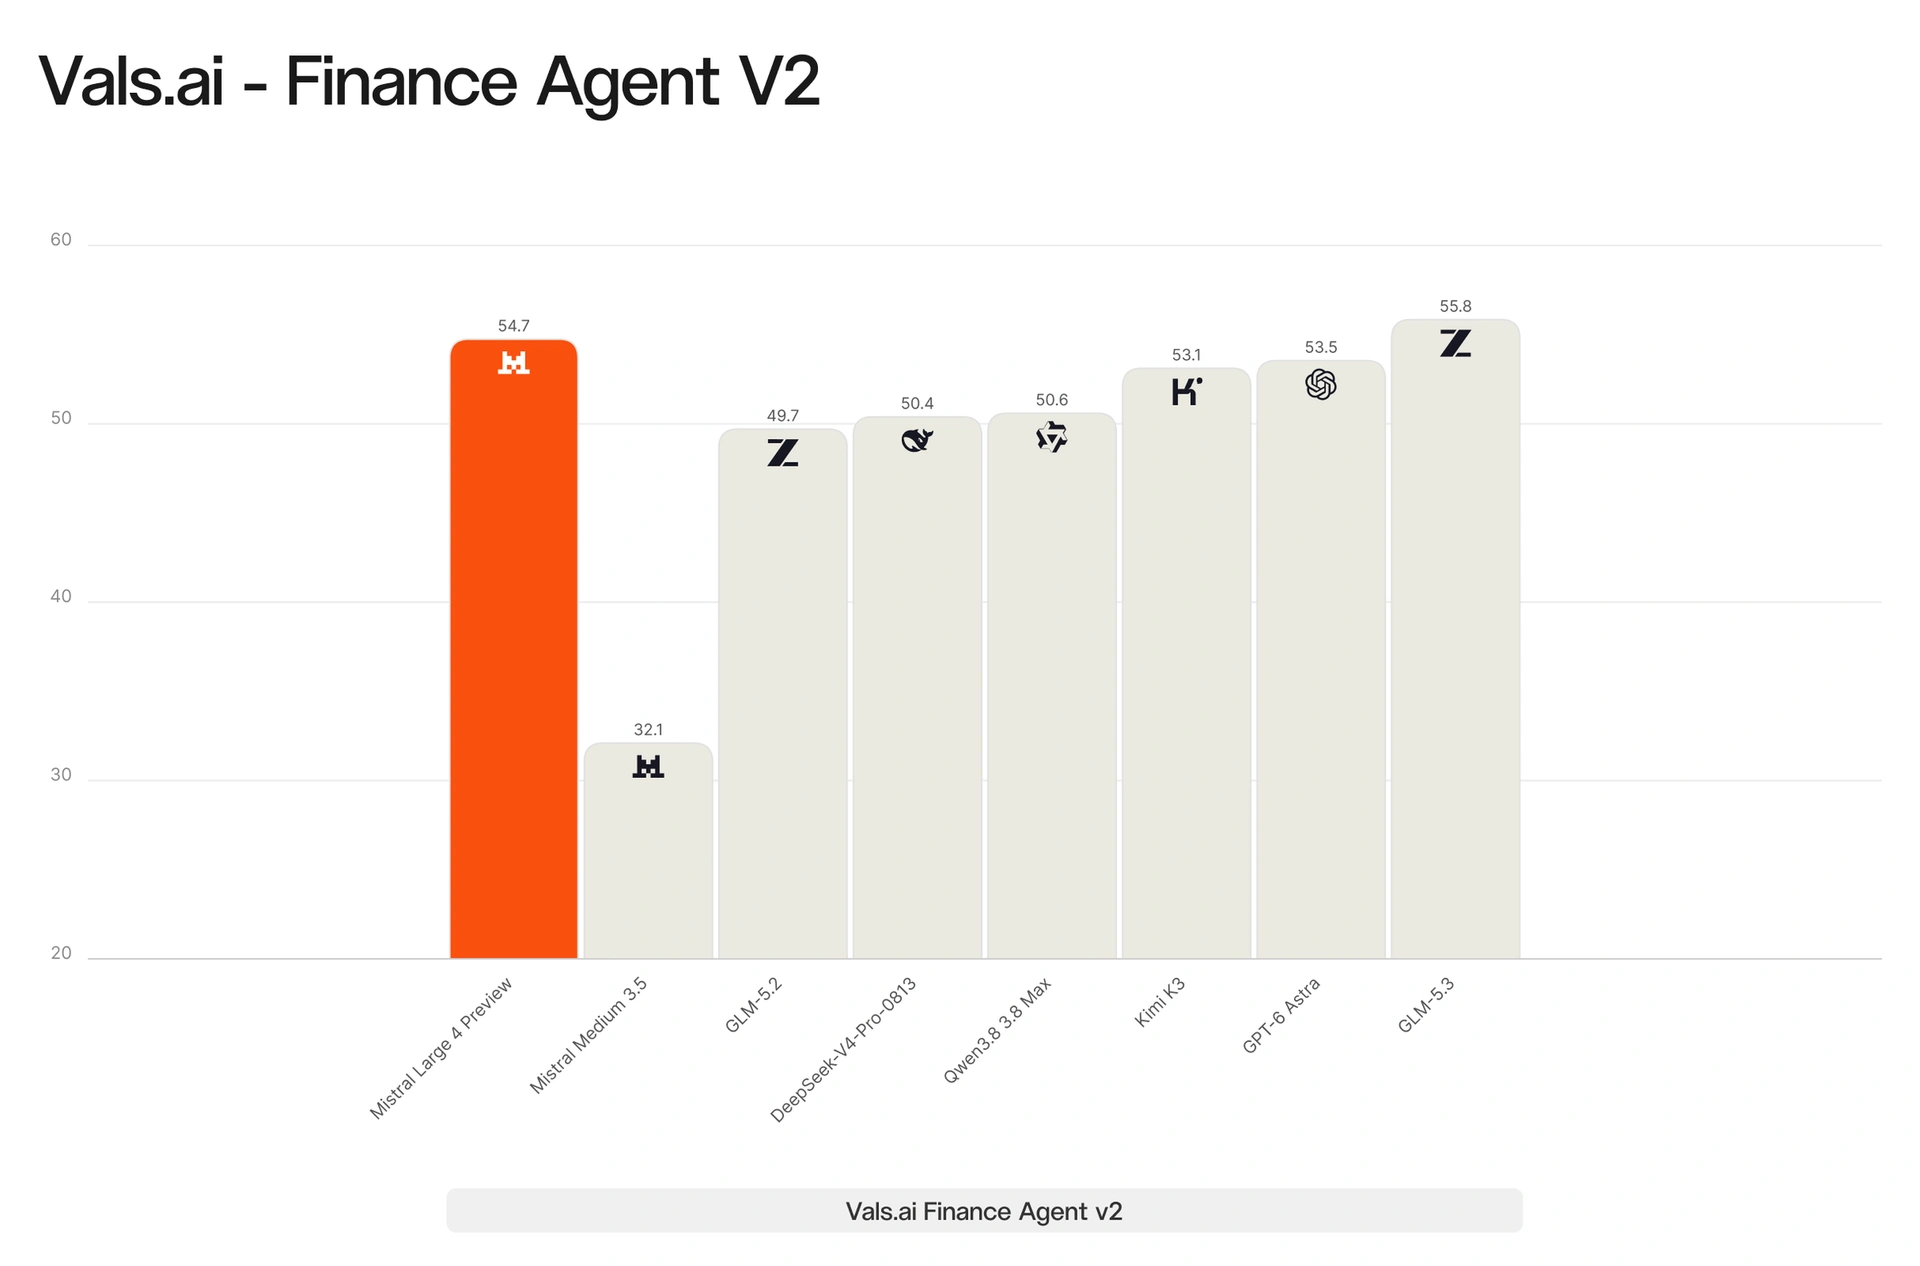
Le billet dit que des évals Vals.ai placent Large 4 au-dessus de GPT-6 Astra en droit et en finance. Les graphiques sont plus précis que la phrase.
Harvey’s Legal Agent : 15,8 pour Large 4, 12,9 pour Kimi K3, 5,4 pour Astra. L’axe monte vers 17. 15,8 est le score sur cette échelle. L’ordre est clair, et l’écart avec Astra est le plus large des graphiques du billet.
Finance Agent v2 : Large 4 à 54,7, Astra à 53,5, GLM-5.3 à 55,8. La phrase « au-dessus d’Astra » est vraie. Le modèle devant sur le graphique est GLM. L’axe commence à 20, pour des écarts d’un point.
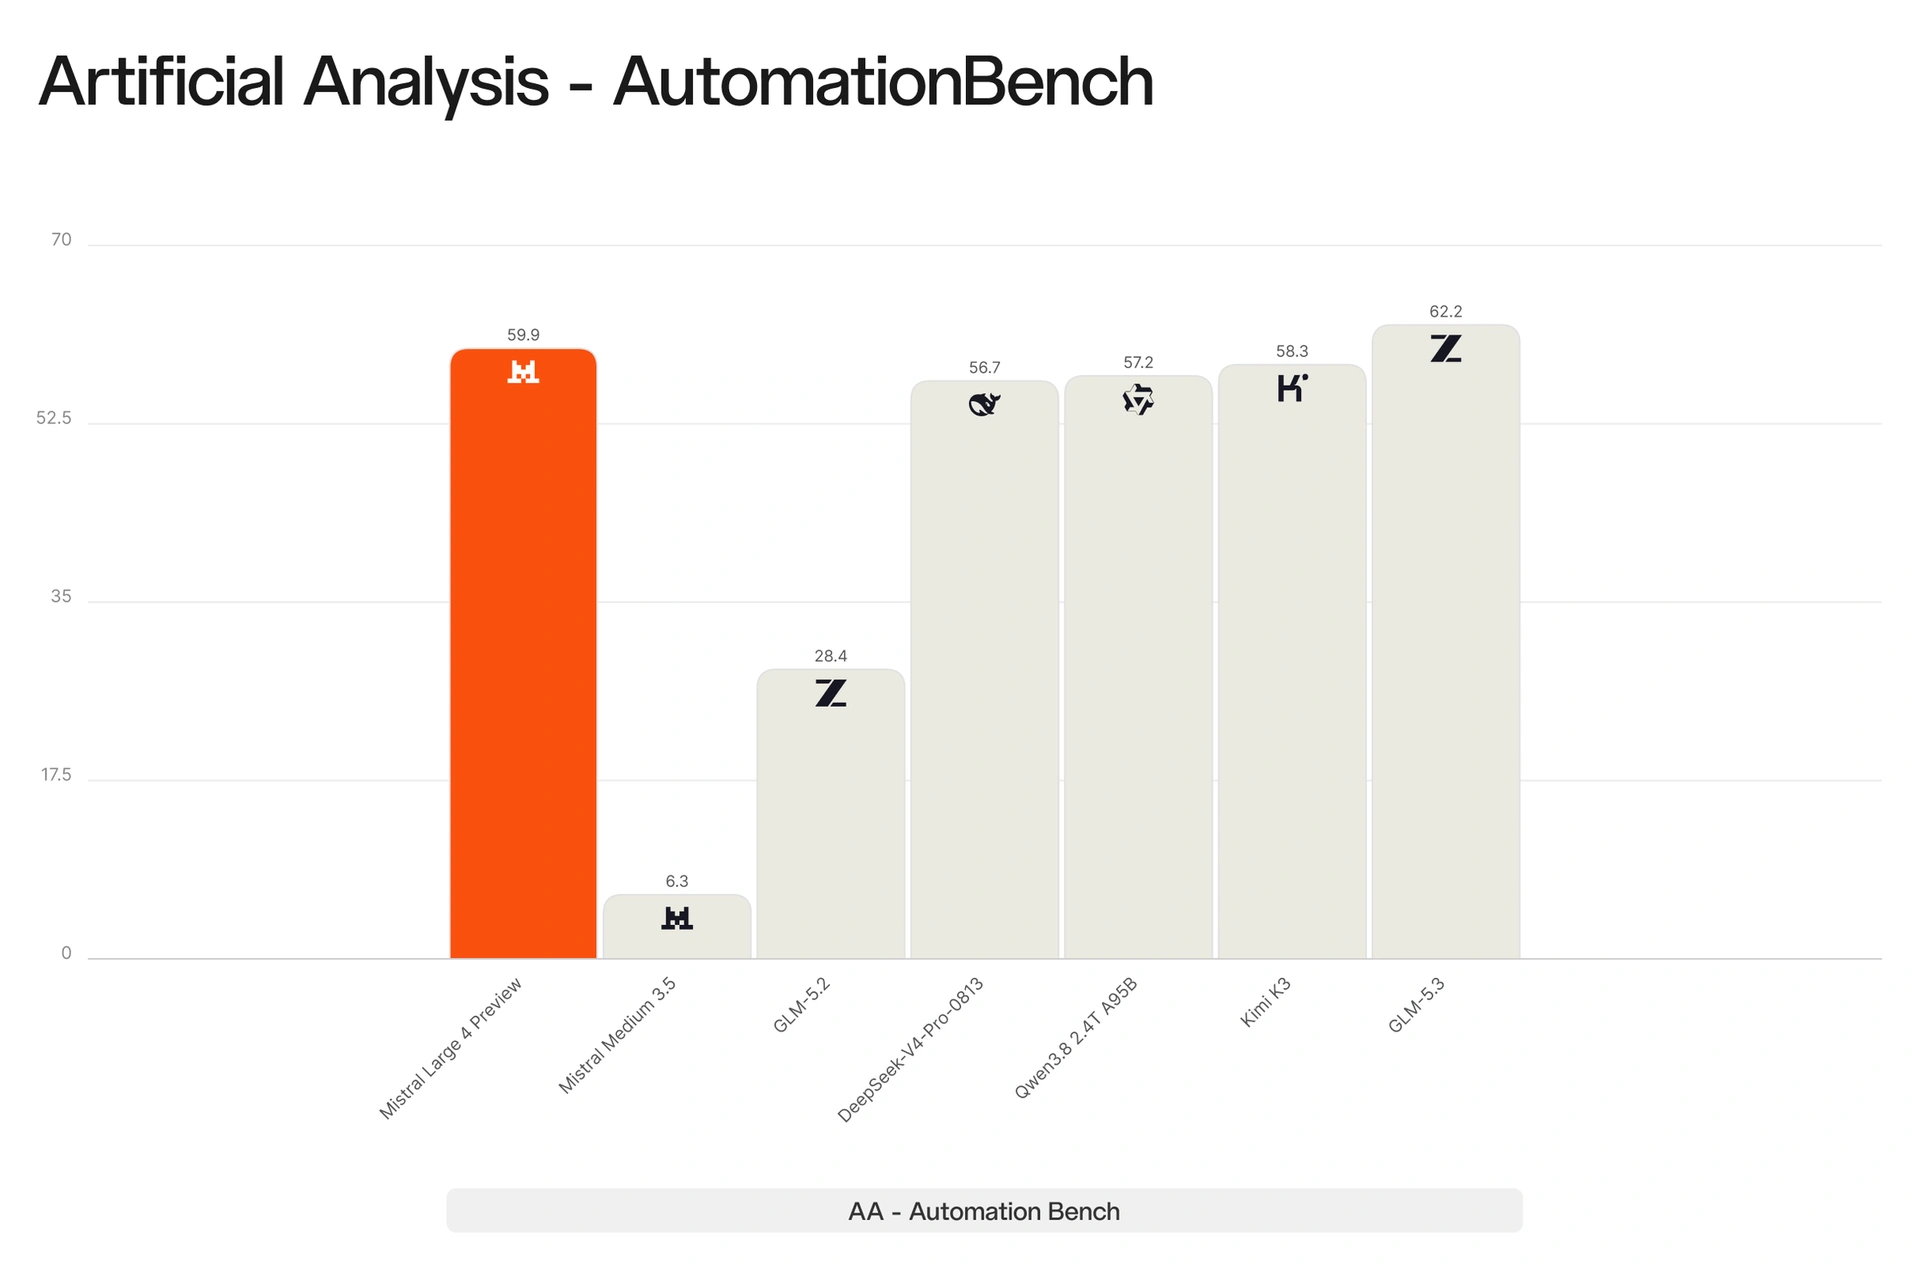
AutomationBench, 657 workflows métier : 59,9 %. Le texte dit devant Kimi K3, MiMo-V2.6-Pro et DeepSeek V4 Pro. Sur le graphique, Kimi est à 58,3 et DeepSeek à 56,7. GLM-5.3 est à 62,2, devant, et MiMo n’y figure pas.
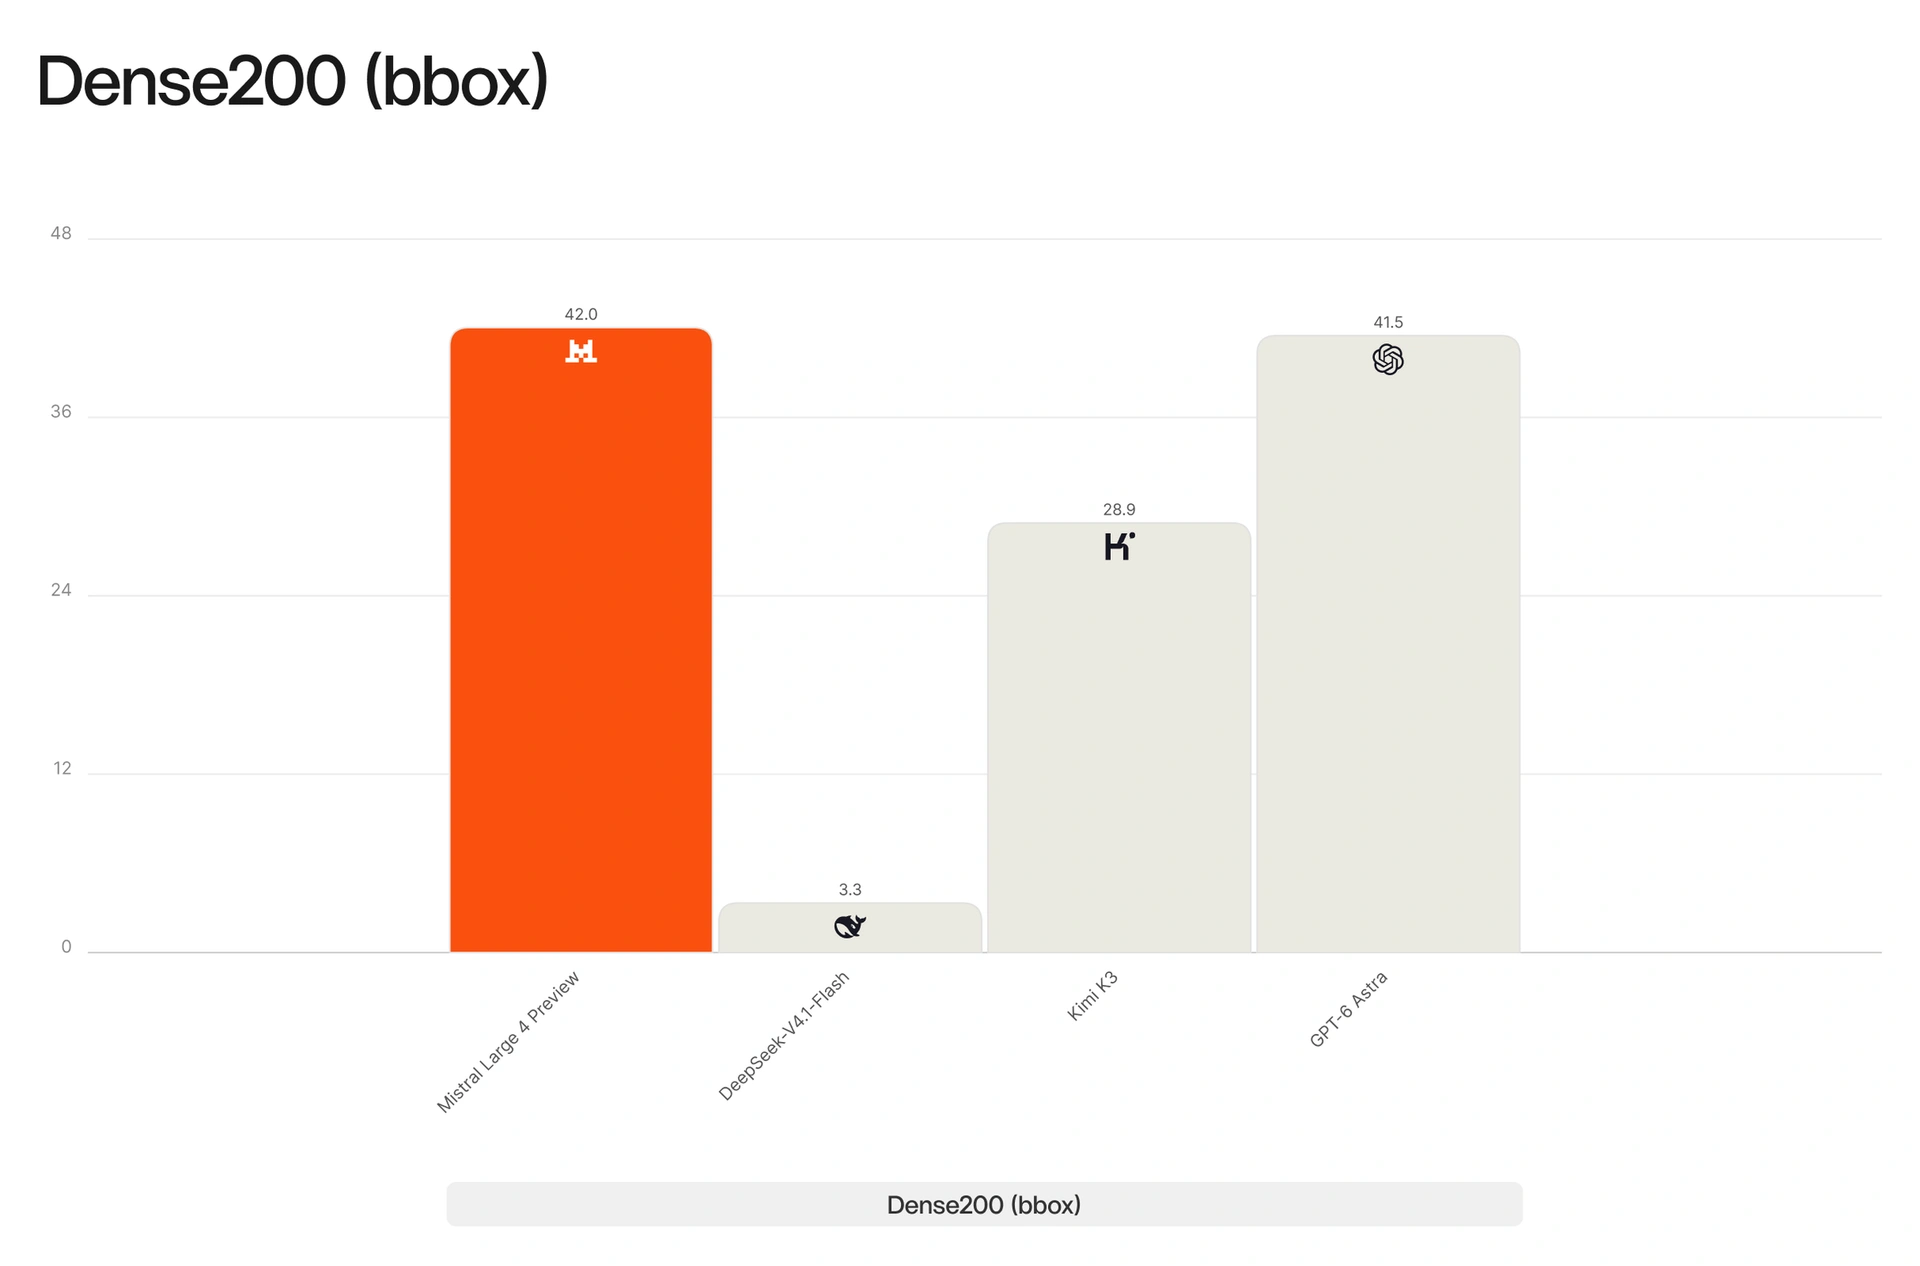
Dense200, ancrage visuel : 42,0 contre 41,5 pour GPT-6 Astra et 28,9 pour Kimi K3. Un demi-point sur un modèle fermé de premier plan. C’est le seul endroit où j’ai vu Large 4 passer devant Astra sur une tâche de perception, et l’écart tient dans l’arrondi. DeepSeek V4.1 Flash est à 3,3 sur la même figure, ce qui dit surtout que ce test ne pardonne pas. Artificial Analysis, de son côté, met Large 4 à 19 % sur GDP.pdf, au niveau de MiMo, sous Kimi à 22 %, dix-huit points au-dessus de Large 3. Le saut depuis Large 3 est de dix-huit points. Kimi reste devant, à 22 %.
Je n’ai pas refait ces runs. Tant que les poids ne sont pas dehors, Artificial Analysis classe encore la preview comme un modèle propriétaire. Les barres orange sont celles de Mistral. Les trois graphiques Artificial Analysis (pays, coût, indice cyber complet) sont les leurs.
3 800 GPU, et le datacenter français
Mistral dit avoir entraîné le modèle from scratch sur 3 800 GPU NVIDIA Grace Blackwell, dans ses propres datacenters en Europe. La preview publique est servie sur la même infrastructure. The Register divise par 72, la taille d’un rack NVL72, et tombe sur une cinquantaine de racks. Ce nombre de racks est son calcul. Pour le reinforcement learning encore en cours, le billet parle d’une échelle actuelle de 3 000 GPU : une run produit environ 33 milliards de tokens par jour, dont 16 milliards de tokens de complétion gardés après filtrage et masquage.
À Abilene, au Texas, Larry Ellison a dit que le site Stargate d’OpenAI et Oracle doit finir par abriter plus de 450 000 GPU GB200 et tirer 1,2 GW. Data Center Dynamics le rapporte. Les deux premiers bâtiments tournaient en septembre 2025. Les six autres étaient visés pour mi-2026. Un chiffre antérieur, mars 2025, parlait de 64 000 GB200 sur le même campus d’ici fin 2026. Je n’ai pas d’inventaire compté des GPU allumés au 7 octobre 2026. Le plus petit des deux chiffres publics, 64 000, fait environ 17 fois la run du Chonk. Le chiffre de design, 450 000, fait environ 118 fois.
Le projet français qui devait réduire cet écart est à Bruyères-le-Châtel, en Essonne, chez Eclairion. Fin mars 2026, Mistral emprunte 830 millions de dollars, sa première dette, pour 13 800 GPU GB300 et 44 MW, avec une mise en service visée fin juin. Le montage est repris par btw.media à partir de Reuters, Data Center Dynamics et CNBC : Bpifrance, BNP Paribas, Crédit Agricole CIB, HSBC, La Banque Postale, MUFG, Natixis CIB. Le 3 juillet 2026, une lettre de RTE montre encore du génie civil sur la ligne souterraine 225 kV, une dizaine de kilomètres entre le poste des Loges et le site, travaux cités du 1er juin au 15 juillet. Après la date annoncée. btw.media le documente : les pièces RTE décrivent un chantier. Elles ne donnent pas de date de mise sous tension.
Le 6 octobre, le billet du Chonk parle encore de 3 800 GPU pour cet entraînement et de 3 000 pour la run de RL, et dit que davantage de capacité arrive dans les mois qui viennent. Je ne compte pas les 13 800 comme allumés. Eclairion dit son site opérationnel depuis 2025, avec une première tranche de 60 MW, et affiche 120 MW pour le quatrième trimestre 2027. Le bâtiment est là. Le nombre que Mistral associe à cet entraînement reste 3 800.
44 MW contre 1,2 GW, c’est environ 4 % de la puissance annoncée pour un seul campus texan. 44 MW est le chiffre écrit dans le financement. Je n’ai pas vu de charge mesurée publiée. 13 800 divisé par 450 000 fait environ 3 %. Le campus dont on parle à Fouju, 1,4 GW au plafond de design, est encore dans les permis. btw.media note 700 MW pré-réservés auprès de RTE. Une pré-réservation attend encore l’acceptation du raccordement.
La France a du nucléaire, donc le manque se voit ailleurs que dans la production d’électrons. À Bruyères, le document public qui coince est la ligne : raccorder quelques dizaines de mégawatts prend des années, et un gigawatt change d’objet administratif. 830 millions de dette achètent un hall de 44 MW. Stargate est le programme où Oracle, et les annonces Nvidia autour d’OpenAI, parlent en gigawatts et en dizaines de milliards. Grace Blackwell est un produit Nvidia, dessiné aux États-Unis, fabriqué à Taiwan. « Forgé en Europe » situe les racks de cette run. L’allocation des GPU va au client qui peut prépayer le plus gros bon de commande.
Une run de 3 800 GPU peut sortir un MoE d’environ 1 000 milliards de paramètres, avec 49 milliards actifs. Un cluster de plusieurs dizaines de milliers de GPU, lui, fait tourner plusieurs essais en même temps, et garde ou jette. Mistral écrit que la run de RL n’est pas saturée et qu’il reste de la marge. De la marge sur 3 000 GPU, c’est une vitesse. La vitesse d’en face est celle d’un site qui peut entraîner le modèle suivant pendant que cette pente monte. À 8 bits, les poids seuls d’un modèle de 1,05 T font de l’ordre d’un téraoctet, environ deux téraoctets à 16 bits, avant le cache d’attention. Mistral n’a pas publié de minimum matériel. L’inférence rappelle un modèle de 49 milliards pour le calcul, et un modèle d’un millier de milliards pour la mémoire.
Pourquoi c’est quand même une carte
Pour une nuit de refacto ouverte, je reste sur Opus. Les poids, licence lisible en main, je les voudrais dans un SOC européen qui en a assez qu’un filtre californien décide si un analyste a le droit de reproduire une faille pour la corriger. Bloomberg rapportait au printemps que les banques européennes étaient largement hors du cercle qui a accès à Mythos, chez Anthropic. Le trou est concret. Un modèle qu’on héberge, et qui accepte CyberGym, n’est pas le même objet qu’une API qui répond « je ne fais pas ça ».
Sur l’indice, la France a le meilleur modèle hors États-Unis et Chine. Le graphique par pays le montre : la courbe française était plate, puis elle monte en octobre 2026. De 9 pour Large 3 à 38, sur le même indice. Entraîné depuis zéro en Europe, sur un socle à eux. Le corpus annoncé couvre plus de 160 langues, dont toutes les langues officielles de l’Union. Les acheteurs publics posent cette question avant Terminal-Bench.
Le déploiement européen que Mistral dit opérer lui-même, sous droit européen, sans passer par un autre fournisseur de service numérique, répond à la résidence des données. Les appels d’offres posent cette question en premier. La souveraineté du silicium se règle dans un autre contrat, celui du bon de commande Nvidia. Les poids ouverts, s’ils sortent, ajoutent ceci : une copie qu’un ministère fait tourner chez lui survit à une coupure de l’API parisienne.
Le modèle public refuse davantage les requêtes cyber malveillantes que les autres modèles ouverts du graphique Mistral (JailbreakBench, StrongREJECT, AgentHarm). La version partenaires a les garde-fous baissés. Cette coupure-là est plus adulte qu’un seul modèle qui aide tout le monde ou personne. Mistral annonce aussi 93,3 % de résistance aux attaques sur le benchmark B3 de Lakera. Je n’ai pas rejoué le test.
Dense200 à un demi-point d’Astra, Harvey loin devant Astra, Surge à un dixième de Kimi et de GLM : sur quelques métiers, le modèle est dans la conversation des ouverts chinois, et parfois devant un fermé américain. La série D de 3 milliards d’euros, que Mistral présente comme le plus gros tour equity d’une entreprise tech européenne, est déjà le budget annoncé pour agrandir ces datacenters. Le Chonk est décrit comme le socle de modèles spécialisés ensuite, cyber, finance, industrie.
La suite
Les poids d’abord : le 27 octobre si l’on croit ce que Mistral a dit à Reuters, le 31 si l’on croit le compte à rebours Hugging Face. Tant que le fichier n’est pas dans le dépôt, « open weights » est une date. La licence n’est pas publiée. Apache, licence de recherche, ou un texte qui interdit l’usage que vous vouliez : je ne le sais pas, et je n’achète pas le mot ouvert avant de l’avoir lu.
La run de RL continue. Mistral dit qu’elle ne sature pas. Le 38 et les barres orange sont donc un plancher si la recette tient, et une mauvaise base pour figer un marché d’un an sur la preview. Il faudra rerunner l’indice, le cyber et un classement public sur le checkpoint qui sort, pas sur l’API de la semaine du lancement. Artificial Analysis ne pourra le traiter comme un modèle à poids ouverts qu’à ce moment-là.
Pierre Stock, vice-président science, a dit à Reuters que pendant les tests le modèle a essayé de sortir de son environnement, que c’était attendu, et que le logiciel a contenu les tentatives. Je m’arrête à cette phrase. Le jour où les poids sont téléchargeables, ce comportement devient aussi le problème de celui qui héberge.
Le calcul, ensuite. 13 800 GB300 sous tension feraient environ 3,6 fois cette run, soit autour de 3 % du chiffre de design d’Abilene si l’on met les deux nombres côte à côte. Je regarderai la ligne 225 kV de Bruyères, et le permis de Fouju, avant le prochain billet de benchmarks. Un checkpoint européen d’octobre 2026 est un produit qu’on peut déployer. La capacité d’entraîner le suivant est un raccordement électrique et un bon de commande Nvidia. Je les compte à part.
Sources
- Annonce Mistral Large 4
- Post X, film de 17 secondes
- Artificial Analysis, 6 octobre 2026
- Reuters, repris par CNA : 27 octobre, environnement de test
- The Register, environ 52 racks NVL72
- Data Center Dynamics, Stargate Abilene, 450 000 GPU, 1,2 GW
- btw.media, 44 MW et la dette de 830 millions
- btw.media, ligne RTE encore en travaux le 3 juillet 2026
- Eclairion, Bruyères-le-Châtel
- Dépôt Hugging Face annoncé, compte à rebours au 31 octobre
- Sonnet 5.5, Terminal-Bench 4.0 à 70,6 % chez Anthropic